· kaynak Hacker News – Front Page (hnrss.org)
Anthropic'in Claude filigranlaması için kalite kaybı yok iddiası, yanıt çeşitliliği konusunda sorgulanıyor
Anthropic filigranlamanın Claude'un çıktı kalitesini etkilemeyeceğini söylüyor, ancak dayandığı SynthID-Text araştırması, aynı prompta verilen filigranlı yanıtların birbirine daha çok benzediğini gösteriyor; bu da yeniden denemeleri ve yaratıcı çalışmaları etkiliyor.
AB şeffaflık kuralları laboratuvarları yapay zeka metinlerini filigranlamaya itiyor
AB Yapay Zeka Yasası'nın şeffaflık yönergeleri yürürlüğe girdi ve blog.keyvan.net'te yayınlanan, Hacker News'in ana sayfasına ulaşan bir blog yazısına göre büyük yapay zeka laboratuvarlarının çoğu, uyum sağlamak için metin çıktılarını yakında filigranlayacaklarını duyurdu. Bu bağlamda filigranlama, modelin kelime seçimlerini gizli, istatistiksel olarak tespit edilebilir bir desenin metni makine üretimi olarak işaretleyeceği şekilde yönlendirmek anlamına geliyor. Anthropic bu tekniği Claude'a uyguluyor; teknoloji yazarı John Gruber ise bu hamleyi, yazının bir sapması olarak nitelendirdiği bir yazıda eleştirdi.
Kalite üzerindeki tartışma
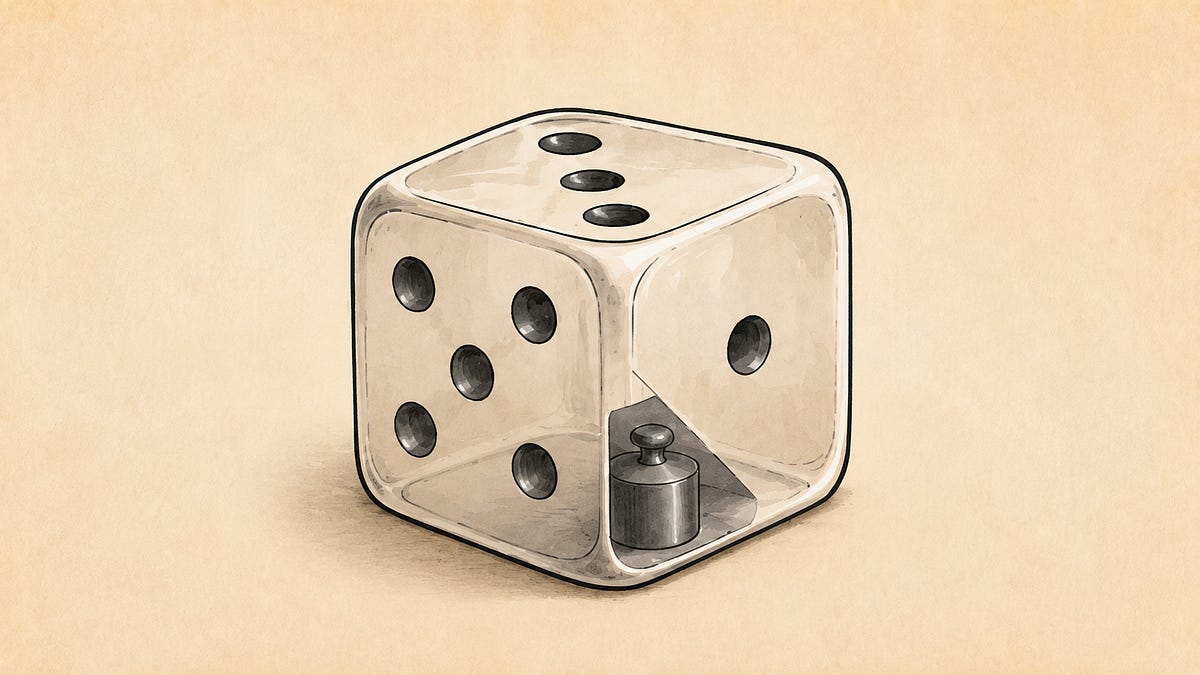
Yazıda aktarıldığına göre Gruber'ın pozisyonu, bir yazım aracının gizli köken izleri gömmek uğruna netlik, tutarlılık veya anlamdan en ufak bir taviz bile vermemesi gerektiği. Bu görüşe epey itiraz geldi. Bazıları bu ortamda kalitenin nasıl tanımlanıp ölçülebileceğini sordu. Başkaları ise filigranlamanın hiçbir maliyeti olmadığını, çünkü yalnızca üretimi yönlendiren rastgele sayıları değiştirdiğini savundu. Gruber'ın daha sonra bağlantı verdiği geliştirici Daniel Jalkut bir benzetme sundu: Çıktısındaki rakamları rutin olarak ters çeviren bir rastgele sayı üreteci tam olarak aynı derecede rastgele kalırdı; başka bir yorumcu da filigranlamayı bir zarın iki yüzünü değiştirmeye benzetti. Gruber etkilenmedi; etkisizlik iddiasının doğru olmasını dilediğini ama bunun son derece düşük ihtimal olduğunu söyledi.
Anthropic, filigranlamanın Claude'un çıktı kalitesini etkilemediğini açıkça belirtiyor. Tasarımı, 2024'te Nature'da yayımlanan bir makalede ele alınan ve benzer şekilde yöntemin yanıt kalitesini koruduğunu söyleyen Google'ın SynthID-Text'ine dayanıyor.
Ek dokümanda gömülü olan ödünleşim
Blog yazısının temel argümanı şu: Bu garantiler tek yanıtlar üzerinde test edildi, oysa milyonlarca insan bu sistemleri yeniden denemeler ve tekrarlanan promptlar içeren süregiden konuşmalar olarak kullanıyor.
Yazının belirttiğine göre, araştırmadan bağlantı verilen 56 sayfalık bir ek doküman, bir çeşitlilik-tespit edilebilirlik ödünleşimini tarif ediyor: Her bir yanıtın kalitesi korunuyor ama birden fazla yanıt arasındaki çeşitlilik korunmuyor. Aynı prompt için birkaç yanıt örneklendiğinde, filigranlı yanıtlar filigransız olanlardan daha çok birbirine benziyor. Araştırmacıların kendileri de bunun, çok sayıda aday üretip en iyisini seçen sistemlere zarar verebileceğini kabul ediyor. Yazı bunu, genel kalitenin düşebileceğinin bir itirafı ve salt bir rastgele sayı değişiminden fazlasının gerçekleştiğinin kanıtı olarak okuyor; zira saf bir değişim böyle bir fark yaratmazdı.
Küçük bir deney
Teknik danışman Natzir Turrado iddiayı doğrudan test etti: SynthID-Text'i açık bir modelde, makaledeki ayarlarla ve bir filigran anahtarıyla, İspanyolca yazarak yeniden üretti. Kıyı kasabasına unutulmaz bir yolculuğu anlatması beş kez istendiğinde, filigranlı model dört yanıta neredeyse tamamen aynı şekilde başladı ve kasabayı anarken şarkı söyleyen ya da dans eden bir kalpten bahsetti. Filigransız model yanıtlarından üçüne farklı şekillerde başladı.
Yazı daha spekülatif bir endişe daha ekliyor: Filigran bir sonraki tokenu seçerken yalnızca kısa bir kayan bağlam penceresine danışıyor; dolayısıyla aynı yakınsama, iki pasaj aynı kısa ifade üzerinden geçtiğinde farklı promptlar arasında da ortaya çıkabilir ve yazım bu tür ifadelerle doludur.
Kullanıcıların fark edeceği yerler
Yazının belirlediği pratik etkiler şunlar:
Yeniden üretme: Tatmin edici olmayan bir yanıt için yeniden dene düğmesine basmak artık gerçekten yeni alternatifler yerine benzer alternatifler döndürme eğiliminde.
Yaratıcı yazım: Çeşitli çıktıdan yararlanan görevler kapsam kaybediyor.
Uzlaşı kontrolü: Güveni ölçmek ve halüsinasyonları azaltmak için yaygın bir teknik, bir promptu tekrarlamak ve uzlaşma aramaktır; ancak filigranlı yanıtlar aynı anahtar tarafından yönlendirilir ve artık bağımsız değildir, bu da görünürdeki uzlaşıyı daha az güvenilir kılar.
Yazı ayrıca makaledeki insan değerlendirmelerinin yalnızca tek yanıtları kapsamış gibi göründüğüne dikkat çekiyor; yani filigrandan en çok etkilenen yön insanlarla hiç test edilmemiş olabilir. Yazar kişisel bir not da ekliyor: Laboratuvarlar kod üretimine öncelik verdiğinden beri model yazımının zaten kötüleştiğine inanıyor ve filigranlama bunu daha da daraltma riski taşıyor.
Neden önemli
Filigranlama, AB kuralları altında yapay zeka üretimi metinler için varsayılan uyum mekanizması olma yolunda ilerliyor; dolayısıyla yan etkileri bu araçları kullanan herkes tarafından, yalnızca uyum ekipleri tarafından değil, hissedilecek. SynthID-Text'in kendi ekinde tarif edilen çeşitlilik kaybı büyük ölçekte geçerliyse, bir yanıtı yeniden üretmek veya birkaç yanıt örnekleme gibi günlük davranışlar ölçülebilir biçimde kötüleşecek; tedarikçi pazarlaması kaliteye dokunulmadığını söylerken. Bu olay ayrıca tek yanıtlı kıyaslamaların gerçek kullanımın neden zayıf bir göstergesi olduğunu ve sıfır etki iddialarının küçük yazılara karşı neden dikkatle incelenmesi gerektiğini gösteriyor. Gruber ile eleştirmenleri arasındaki tartışma soyut görünebilir ama artık arkasında regülasyon gücü var.
- #eu-ai-act
- #watermarking
- #anthropic
- #claude
- #ai-policy