· kaynak Hacker News – Front Page (native)
Cartesia'nın hiyerarşik ağları tokenization'ı öğreniyor ve 10 kata kadar compute tasarrufu iddiasında bulunuyor
Cartesia, elle tasarlanmış tokenizer'ları modelin içinde öğrenilen chunking ile değiştiren hiyerarşik ağlarının, 10 kat daha az compute ve veri kullanarak tokenized Transformer'lara eşit ya da daha iyi sonuçlar verdiğini söylüyor.
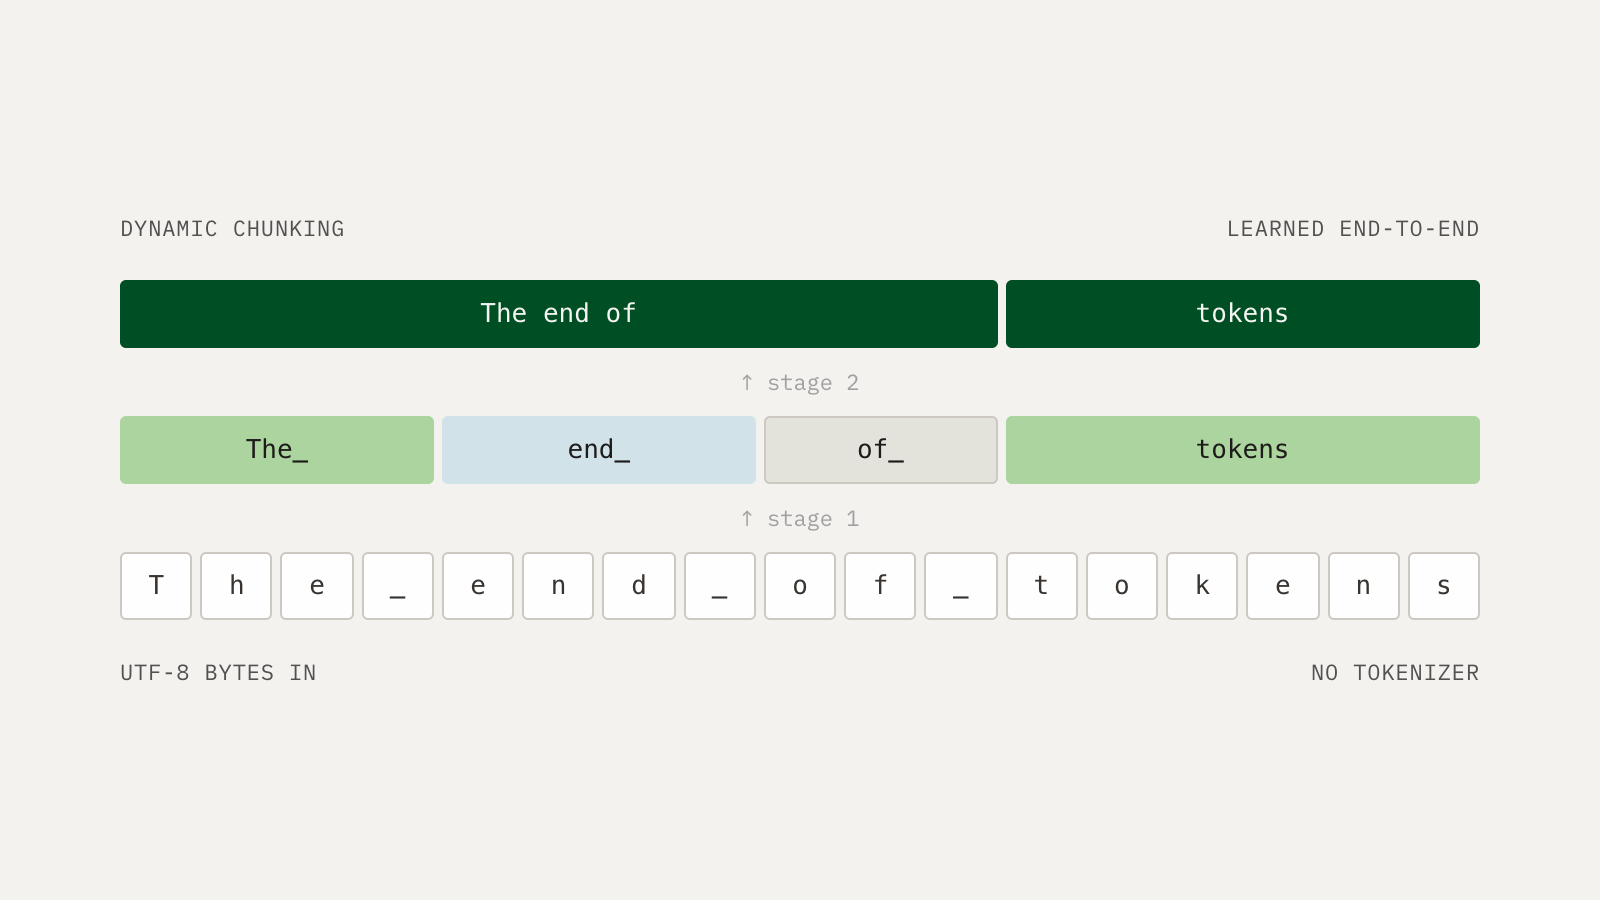
Cartesia hiyerarşik ağları tokenized Transformer'ların ötesine taşıyor
Cartesia, tokenization'ı modelin içine taşıyan ve uçtan uca öğrenen bir mimari olan hiyerarşik ağlar (H-Nets) üzerine iki bölümlük bir yazı dizisinin ilk yarısını yayımladı. Şirketeye göre dikkatlice kontrol edilmiş tek aşamalı bir H-Net, eşdeğer bir tokenized Transformer'dan 3–5 kata kadar daha compute-verimli; daha büyük iki aşamalı bir H-Net ise eşleştirilmiş bir açık kaynak modeli, yaklaşık 10 kat daha az compute ve veri kullanarak geride bırakıyor. Yazı Hacker News'in ön sayfasına ulaştı.
El yapımı son adım olarak tokenization
Cartesia çalışmayı "bitter lesson" bağlamına yerleştiriyor: Richard Sutton'ın 2019'daki argümanı, compute ile ölçeklenen genel yöntemlerin insan öngörüleriyle inşa edilmiş sistemleri geride bırakma eğilimindedir. Şirketin okumasına göre zekâ, ham ve dağınık veriden doğrudan öğrenmek anlamına gelmelidir: desenleri bulmak ve soyutlamaları özerk biçimde, uçtan uca inşa etmek.
Dil modelleri büyük ölçüde bu tarifi izliyor — transformer mimarileri, next-token prediction, reinforcement learning ve test-time computation hep ölçeklenmeyi ödüllendiriyor — ama tokenization etmiyor. Modeller metni okumuyor; sabit bir kelime dağarcığından gelen token'ları okuyor ve bunlar tipik olarak Byte Pair Encoding ile üretiliyor. BPE, 256 byte değerinden başlar ve kelime dağarcığı Llama-3'teki gibi 128k gibi bir hedef boyuta ulaşana dek sabit bir külliyat üzerinde en sık bitişik çiftleri tekrar tekrar birleştirir. Cartesia'nın veri karışımında her token yaklaşık 4,57 byte'a karşılık geliyor; bu dizileri kısaltıyor ama bir sıkıştırma kararını, eğitim daha başlamadan pipeline'a donduruyor.
H-Nets chunking'i nasıl öğreniyor
Cartesia'nın 2025'te tanıttığı H-Nets aynı sıkıştırmayı dinamik biçimde yapıyor. Ad, şirketin insan zekâsının vazgeçilmez bir parçası olarak nitelediği bilişsel psikolojideki chunking kavramından geliyor. Yazıda anlatıldığı gibi bir girdi beş modülden geçiyor: bir encoder byte gibi ham girdileri okuyor; öğrenilmiş bir chunking adımı bunları birkaç chunk'a sıkıştırıyor; bir ana ağ bu kaba chunk'ları, bir Transformer'ın token'ları işlediği gibi işliyor; chunk'lar tekrar girdi çözünürlüğüne açılıyor ve bir residual connection ile ekleniyor; ve bir decoder çıktıyı üretiyor.
Tanımlayıcı özellik iç içe geçme (nesting). Ana ağın kendisi de bir H-Net olabilir; böylece iki aşamalı bir model karakterleri kelime benzeri birimlere, kelimeleri de ifade ya da kavram benzeri birimlere dönüştürebilir. Cartesia ayrıca tasarımın metne, hatta ayrık verilere bile bağlı olmadığını söylüyor; bu da önemli, çünkü sürekli veriyi tokenize etmek hâlâ çözülmemiş bir sorun.
Ölçekleme sonuçları
Orijinal H-Net çalışması, birçok mimari araştırması gibi, ön eğitim yenilikleri için artık standart ölçüt olan compute-optimal ölçekleme yasalarını belirlemek yerine sabit boyut ve veri bütçelerinde modelleri ayarlamaya odaklanmıştı. Yeni yazı bu eksik parçayı sunuyor:
Tek aşamalı bir H-Net, tokenized Transformer'lardan oluşan standart bir ölçekleme basamağına göre ölçüldüğünde, yalnızca öğrenilmiş tokenization'dan 3–5 kata kadar compute verimliliği kazancı sağlıyor.
Ölçeklenmiş iki aşamalı bir H-Net, eşleştirilmiş bir açık kaynak modeli yaklaşık 10 kat daha az compute ve veriyle geride bırakıyor.
Modellerin ne öğrendiğine dair analiz, Cartesia'ya göre daha önce dil modellerinde görülmemiş, in-context tokenization da dahil bir davranış yelpazesi gösteriyor.
Şirket, sonuçların H-Nets'in önemli ölçüde iyileştirilmiş, yayımlamayı planladığı bir sürümünden geldiğini belirtiyor. İkinci bir yazı, verimliliğin nereden geldiğini açıklamak için daha geniş bir model yelpazesini inceleyecek.
Dil modellemenin ötesinde
Yazı ayrıca H-Nets'i biyoloji ve görüye uygulayan devam eden çalışmaları önizliyor ve mimariyi yalnızca tokenization için bir düzeltme değil, modalar genelinde genel bir temel olarak konumlandırıyor.
Neden önemli
Tokenization, dil modeli pipeline'ının elle tasarlanmış而非 öğrenilmiş son bileşenlerinden biri ve alanı yönlendiren ölçekleme felsefesiyle doğal durmuyor. Cartesia'nın rakamları tutarsa, öğrenilmiş chunking yalnızca daha derli toplu olmayacak — belirli bir performans düzeyine ulaşmak için gereken compute miktarını değiştirecek ve özel ön işleme olmadan ham byte'ları, pikselleri ya da biyolojik sinyalleri alabilen mimarilere işaret edecek. Cartesia, byte düzeyinde dil modellemeyi genel öğrenme yöntemleri için bir sınav alanı olarak çerçeveliyor: bir sistem ham karakterlerden dili öğrenemezse, insan öngörülerinin inşasının en zor olduğu bilim, robotik ve biyoloji gibi veri kıtlığı çeken alanlardaki umutları sınırlı görünüyor. Yine de uyarılar gerçek. Rakamlar, sonuçta payı olan bir şirket tarafından kendisi raporlanıyor, eşleştirilmiş baseline bu ilk yazıda adlandırılmıyor ve tek laboratuvarın ölçekleme iddiaları alan tarafından kesin kabul edilmeden önce tarihsel olarak bağımsız doğrulama gerektirmiş durumda.
- #language-models
- #transformers
- #tokenization
- #deep-learning
- #research