· kaynak Hacker News – Front Page (native)
d-Matrix Raptor, Hot Chips 2026'da 100 TB/s çıkarım hedefiyle DRAM üzerine logic yerleştiriyor
Hot Chips 2026'da d-Matrix, LLM decode'daki bellek bant genişliği duvarına saldırmak için bir N4 logic die'ını DRAM üzerine bağlayan ve 100 TB/s mertebesini hedefleyen 3D-DRAM çıkarım hızlandırıcısı Raptor'u detaylandırdı.
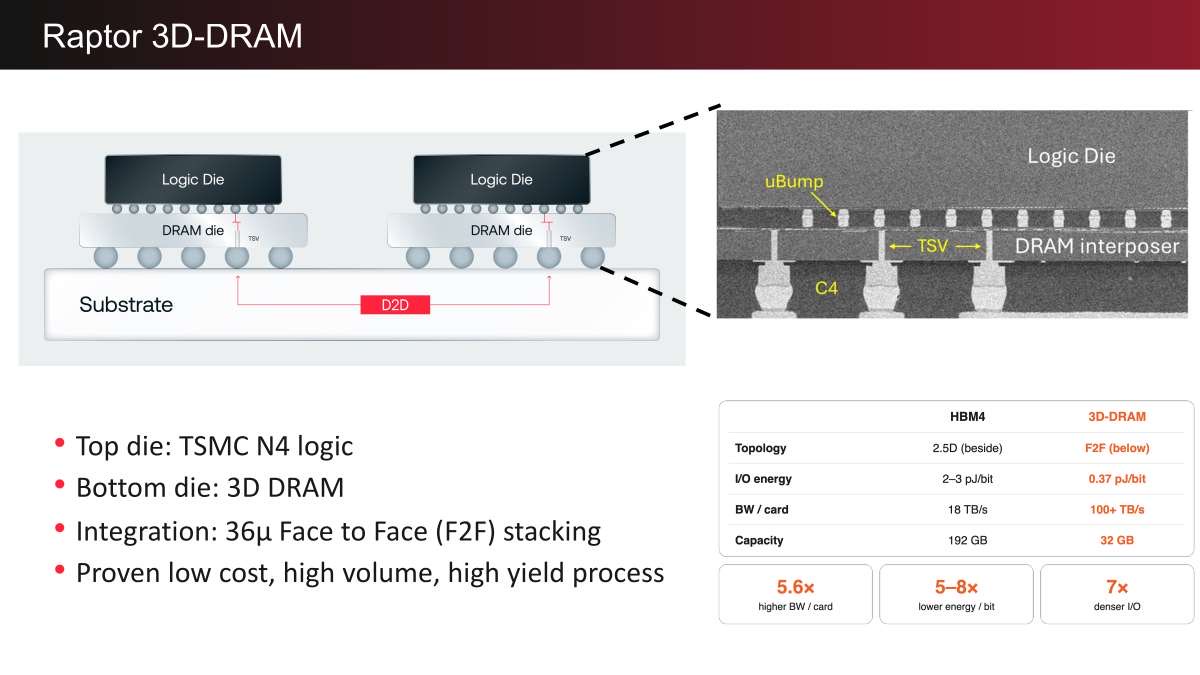
Hot Chips 2026'da d-Matrix, TSMC N4 bir logic die'ı 36 mikron face-to-face bağlama ile doğrudan 3D DRAM die üzerine yığarak yerleştiren Raptor adlı üretken çıkarım hızlandırıcıyı tanıttı. Konuşmanın ServeTheHome'daki canlı haberine göre tasarım, aynı anda iki eksende büyüyen bir sorunu hedefliyor: model ağırlıkları genişlemeye devam ediyor ve KV cache, bağlam uzunluğu ile batch boyutunun çarpımıyla ölçekleniyor. Şirket, bir milyon token bağlamda 64 kullanıcının tek başına kabaca 935 GB KV cache gerektireceğini tahmin ediyor; bu da hem kapasite hem de bant genişliği sorunlarının sürekli kötüleşmesi anlamına geliyor.
d-Matrix'in nişan aldığı bellek duvarı
d-Matrix, tasarım alanını bir dizi ödünleşim merdiveni olarak çerçevelendirdi. SRAM aşırı bant genişliği sunuyor — şirketin önceki Corsair kart çifti yaklaşık 1 ns gecikmeyle kabaca 300 TB/s'e ulaştı — ama yalnızca 4 GB civarı tutabiliyor, çünkü bir 6T SRAM hücresi bir DRAM hücresinden kabaca on kat büyük ve gigabayt ölçeğinde kaçak güç onlarca wata ulaşıyor. Bu, SRAM'i speculative decoding'de bir draft model için uygun kılıyor, sınır modellerin ağırlıklarını saklamak için değil.
HBM ise bu ödünleşimi tersine çeviriyor: kapasite yeterli, bant genişliği değil. Pin hızı ve base die başına I/O genişliği yavaş iyileşiyor ve mevcut paket sahil şeridi tasarımları kabaca 8–16 stack ile sınırlıyor. d-Matrix, NVIDIA'nın Vera Rubin ve AMD'nin Instinct MI455 gibi HBM4 paketleri için 20 TB/s civarında pratik bir tavan gösterdi; ayrıca dik bir güç cezası var: 2.4 pJ/bit ile 100 TB/s'i HBM üzerinden taşımak, herhangi bir fabric trafiği sayılmadan yaklaşık 1.92 kW tüketiyor.
Hesaplamayı DRAM'in kendisine yerleştirmek bu uçlar arasında bir yerde duruyor. Dikey 3D I/O kabaca 0.3–0.4 pJ/bit maliyetle geliyor; sinyaller santimetre ölçeğinde bir interposer yolunu değil, PHY'siz milimetre ölçeğinde bir yolu kat ettiği için bu, 2.5D HBM4 sistemlerinin 2.5–5 pJ değerinin yaklaşık on katı altında. HBM'den daha az yığılmış katman, daha iyi verimle daha büyük bir die'a da izin veriyor. Sorun ise ısı: d-Matrix, 0.5 W/mm² veya altında tutulan 1-Hi logic-on-top bir yığının sıvı soğutmayla DRAM 100°C'nin altında kalacak şekilde soğutulabileceğini söylüyor.
İş yükü argümanı her şeyi birbirine bağlıyor. Prefill birçok prompt tokenını paralel işler ve hesap bağlantılıdır; decode ise aynı anda tek token üretir ve bellek bant genişliğine bağlıdır. Decode, toplam çıkarım süresine hâkim olduğu için d-Matrix, decode bant genişliğini iyileştirmenin genel çıkarım performansını iyileştirdiğini savunuyor. Kart başına 32 GB, 4-bit ağırlıklar ve 8-bit KV cache ile şirket, 72 kartlık bir rafın sınır sınıfı bir modeli barındırmasına yeteceğini boyutluyor — 1M bağlamda Kimi K3'ü adlandırdı — ve disaggregation ile çok raflı yapılandırmalar tek bir Raptor rafının ötesine uzanıyor.
İç içe geçmiş üç mühendislik problemi
ServeTheHome kapsamı, zor kısımların birbirinden bağımsız olmadığı d-Matrix noktasına dikkat çekti: bank mapping, I/O gücü ve termal güvenilirlik her biri diğerlerinin tasarım alanını kısıtlıyor.
Bank mapping önce geliyor. Her tensor engine erişim başına 128 baytluk bir flit istiyor ve 32 baytlık banklar her sütun erişiminde 32 B döndürüyor; bu da kanal başına dört bank gerektiriyor. Die üzerinde 840 bank var — 72 yedek sonra 768 — 256 kanala yayılmış durumda, yani kanal başına yalnızca üç bank kalıyor. 128 B'lik bir fliti basitçe sunmak, 192 B getiren iki 96 B erişim alıyor ve 33 TB/s civarında bant genişliğinin yaklaşık üçte birini boşa harcıyor. d-Matrix'in çözümü olan stream blocking, bir kısmi erişimi üç flit arasında paylaşıyor: dört 96 B erişim üç 128 B fliti besliyor, 384 bayt girişte ve 384 çıkışta; bu da kaydırmalı tampon olmadan fazla getirmeyi ortadan kaldırıyor.
Sonra I/O gücü var. 100 TB/s'i 0.37 pJ/bit ile taşımak yalnızca linkler için 296 W maliyetlendiriyor ve geleneksel data-bus inversion yüzde 20 tasarruf sağlayabilirdi — ama tek çevrimlik 256-bit 3D link'te çok çevrimli burst yok ve ters çevirmeleri bildirecek yan bant pini yok. Şirketin stream flipping çözümü her fliti öncekiyle karşılaştırıyor ve işe yaradığında ters çeviriyor; bunun sinyali ECC ile birlikte taşınan tek bir metadata bitiyle veriliyor, yüzde 0.8 ek yükle ve PHY değişikliği olmadan.
105°C eklem sıcaklığında güvenilirlik üçüncü problem. Retention süresi 85°C'de 32 ms'den 105°C'de 4 ms'ye düşüyor ve sekiz kat daha fazla refresh gerektiriyor; 840 bankla yüzde 1'lik bile hata oranı bütün kanalları tehdit ederken bağlanmış die'ları atmak ekonomik değil. d-Matrix, ECC ve DBI bitlerini her subarray'in son sütunlarına serpiştiriyor ve standart ECC'yi bir Reed-Solomon koduyla eşliyor; 16 ila 32 kat daha az satır okunduğu için ek refresh yalnızca bant genişliğinin yaklaşık yüzde 1.37'sine mal oluyor ve verimi 100 TB/s civarında tutuyor. İki mux seviyeli bank chaining ise 72 yedek bankın die üzerindeki herhangi bir yerdeki hataları emmesine izin verirken kanallar simetrik kalıyor.
Neden önemli
Decode zamanındaki bellek bant genişliği, çıkarım ekonomisinin bağlayıcı kısıtı ve HBM yol haritaları bunu güç bütçeleri daralırken yavaş iyileştiriyor. Raptor bunun yerine hesaplamayı belleğin içine taşımanın en somut kamuya açık girişimlerinden biri; fazla getirim, I/O gücü ve refresh için açıklanmış ek yüklerle birlikte — genellikle ticari sır olarak kalan rakamlarla. 3D DRAM istiflemenin hacimde verim verip soğutulup soğutulamayacağı hâlâ kanıtlanmadı ve sunum canlı haberde kısa kesildi. Ama sergilenen detaylı mühendislik, near-memory compute'un sınır modellerine gerçekçi biçimde nasıl hizmet edebileceğine dair bir şablon çiziyor.
- #ai-hardware
- #compute-in-memory
- #dram
- #llm-inference
- #hot-chips