· kaynak Hacker News – Front Page (native)
DBOS'un tespiti: Postgres SELECT DISTINCT, indekslemeden bağımsız olarak eşleşen her satırı tarıyor
DBOS, Postgres'te SELECT DISTINCT'in her zaman eşleşen tüm satırları taradığını, dolayısıyla gecikme süresinin benzersiz değer sayısına değil tablo boyutuna göre ölçeklendiğini bildirdi; şirket özyinelemeli CTE tabanlı bir geçici çözüm yayınladı.
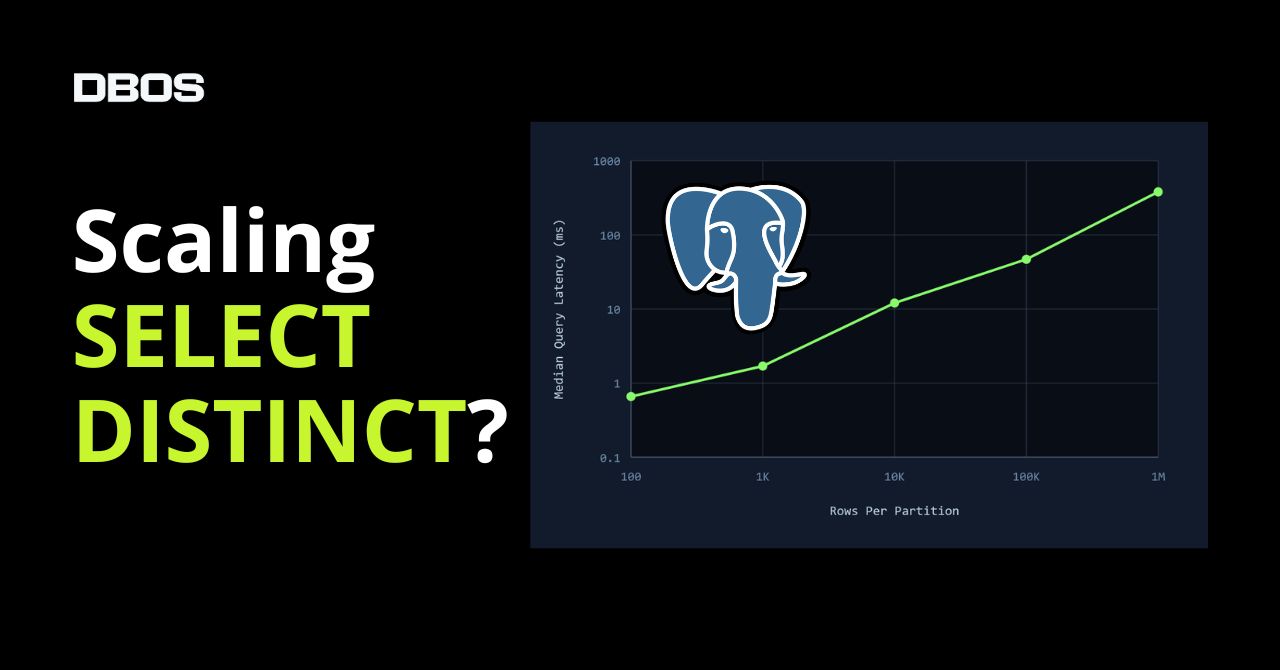
DBOS ne buldu
Postgres üzerinde dayanıklı yürütme (durable execution) altyapısı geliştiren DBOS'un mühendislik ekibi, veritabanının en tanıdık özelliklerinden birindeki bir ölçeklendirme tuzağını belgeledi. Şirketin mühendislik blogunda yayınlanan bir yazıya göre, bir sütunun benzersiz değerlerini döndüren SELECT DISTINCT ifadesi, sorgunun koşullarına uyan her satırı her zaman tarıyor. Hiçbir indeksleme stratejisi bunu değiştirmiyor; getirilen benzersiz değerlerin sayısı da değiştirmiyor.
Ekip bu sorunla Postgres tabanlı bir kuyruk (queue) iş yükünü teşhis ederken karşılaştı. Kuyruklar, kurulumlarında kullanıcı başına bir tane olacak şekilde bölümlere ayrılmıştı; böylece akış kontrolü bağımsız olarak uygulanabiliyordu — örneğin her kullanıcının aynı anda en fazla bir görev çalıştırması sağlanabiliyordu. Kuyruktan çıkarma işlemi, etkin bölümleri, yani ENQUEUED durumunda en az bir iş akışı barındıranları bulmakla başlıyor ve bölüm anahtarı (partition key) üzerinde SELECT DISTINCT bunu ifade etmenin doğal yoluydu.
Varsayım nerede çöktü
Sorgu, kuyruk adı, iş akışı durumu ve bölüm anahtarı üzerindeki bir indeks tarafından iyi destekleniyor görünüyordu. İndeks bu hiyerarşi boyunca sıralandığından DBOS, Postgres'in her benzersiz bölüm anahtarının ilk satırına doğrudan atlayacağını ve maliyetin etkin bölüm sayısıyla orantılı olacağını umuyordu.
Bu varsayım, çok sayıda bölüm ama bölüm başına az sayıda kuyruğa alınmış öğe içeren iş yüklerinde geçerliydi. Ters şekilli iş yüklerinde, yani az sayıda bölümün her birinin çok büyük sayıda kuyruğa alınmış öğe barındırdığı durumlarda çöktü. Bir milisaniyenin altında tamamlanması gereken sorgular saniyeler sürdü.
Bir benchmark nedeni izole etti. Bölüm sayısı onda sabit tutulup bölüm başına satır sayısı 100'den bir milyona ölçeklendirildiğinde, sorgu gecikmesi satır sayısıyla doğrusal olarak büyüdü. Sorgu, benzersiz bölüm anahtarlarının sayısı yerine kuyruğa alınmış iş akışlarının toplam sayısıyla ölçekleniyordu — DBOS'un incelediği planda, yalnızca üç benzersiz anahtar üretmek için bir milyon satır okunuyordu.
Planner'ın neden daha iyi bir seçeneği yok
Yazıya göre Postgres'in ürettiği plan fiilen tam bir indeks taraması: indeksi baştan sona geziyor, eşleşen her satırı çekiyor ve her birini benzersizlik açısından kontrol ediyor. Bu israf bir planlama hatası değil, yapısal bir durum — Postgres'te uygulanan tüm indeks tarama operatörleri koşulları sağlayan tüm indekslenmiş değerleri alıyor, dolayısıyla planner'ın seçebileceği bir kısayolu yok.
Yazı bunu, sorgunun koşullarını sağlayan yalnızca her benzersiz değeri getiren bir loose index scan operatörü sunan MySQL ile karşılaştırıyor. Postgres 18, en soldaki sütun dışındaki bir sütunda aranan çok sütunlu indeksler için bir skip-scan optimizasyonu ekledi, ancak DBOS bunun hâlâ koşullara uyan her satırı ziyaret ettiğini ve bu nedenle SELECT DISTINCT'i hızlandıramadığını belirtiyor. Gerçek bir loose index scan eklemek için 2018'de başlayan ayrı bir çaba, dört yıllık çalışma ve maintainer değişimlerinin ardından yarım bırakıldı.
Geçici çözüm
SELECT DISTINCT Postgres'te ölçekte kullanılamaz olduğu için DBOS, onu özyinelemeli bir common table expression üzerine kurulu, bilinçli olarak beceriksiz bir sorguyla değiştirdi. Bu sorgu bir imperatif döngü gibi davranıyor: ilk yineleme, sıralı indeks üzerinde min() kullanarak en küçük bölüm anahtarını seçiyor ve sonraki her yineleme, bir öncekinden büyük olan sıradaki anahtarı seçiyor. Her yineleme tek bir değer okuyor, dolayısıyla toplam maliyet benzersiz bölüm sayısıyla orantılı.
Şirket, yeniden yazımı aynı benchmark şekliyle — on bölüm, her birinde bin ile bir milyon arasında satır — doğruladı ve medyan gecikmenin bölümler büyüdükçe artmadığını bildirdi.
Neden önemli
SELECT DISTINCT, birçok ekibin indeksli bir arama gibi davrandığını varsayacağı kadar yaygın. DBOS'un ölçümleri, bunun WHERE koşuluna uyan her şeyin taranması gibi davrandığını gösteriyor; bu da gecikmenin sonuç boyutuna değil veri hacmine bağlı olduğu anlamına geliyor. Bu özellik küçük tablolarda görünmez kalıyor ve üretimde genellikle kuyruklar, olay tabloları ve loglar büyüdükçe ortaya çıkıyor. Büyük Postgres tablolarında kiracı listeleri, panolar veya tekilleştirme (deduplication) için benzersiz değer sorguları çalıştıran herkes, sorgu planlarında tam indeks taraması olup olmadığını kontrol etmeli. Postgres gerçek bir loose index scan sunana kadar pratik seçenek, özyinelemeli CTE deseni ile veriler biriktikçe sessizce yavaşlayan sorgular arasından birini yapmak.
- #postgres
- #databases
- #performance
- #sql
- #query-optimization