· kaynak Hacker News – Front Page (native)
E-means, EMA mini-batch güncellemeleriyle eşit kayıpta 10-45 kat daha hızlı k-means iddiasında
E-means, üstel hareketli ortalama güncellemelerine dayanan mini-batch tabanlı bir k-means yeniden tasarımı; en iyi Lloyd uygulamasına kıyasla eşit ya da daha iyi kayıpta GPU'da 10-45 kat hızlanma iddia ediyor ve hiperparametreleri ölçekleme yasalarıyla otomatik olarak belirliyor.
Eski bir iş atına yeni bir bakış
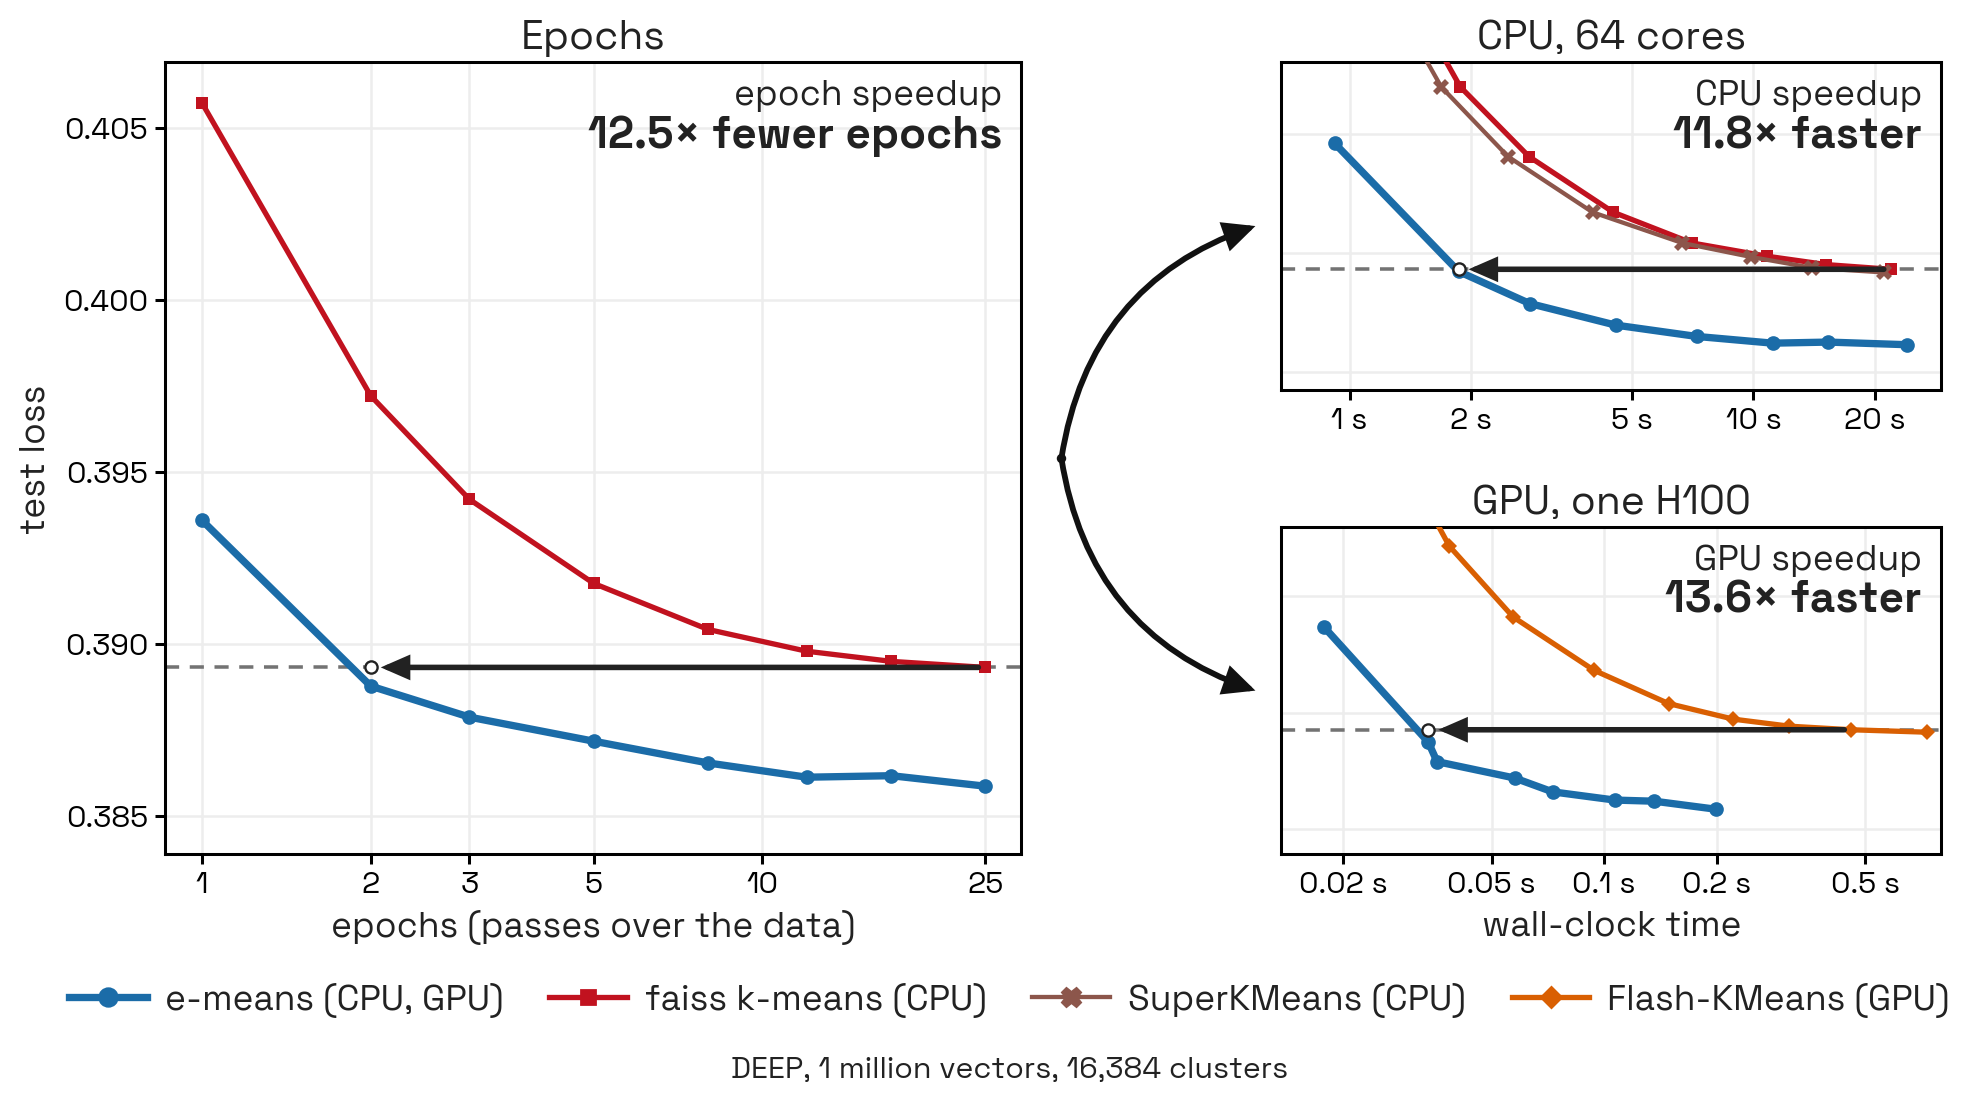
E-means adlı bir proje, çözüm kalitesinden ödün vermeden mertebesinde hızlanmalar vaat eden bir k-means kümeleme yeniden tasarımı yayımladı. Yakın zamanda Hacker News ana sayfasına çıkan proje dokümantasyonuna göre e-means, Lloyd algoritmasının 25 epoktadan sonra ulaştığı test kaybından daha iyi bir değere yalnızca 1,2 ila 3 epokta ulaşıyor. Proje, uçtan uca ölçümlerde en gelişmiş Lloyd uygulaması olarak tanımladığı Flash-KMeans ile karşılaştırıldığında GPU'da 10-45 kat, Faiss ile karşılaştırıldığında CPU'da 8-15 kat duvar saati süresi azalması bildiriyor. Kümelemede hız ve kalite normalde zıt yönlerde çeker; projenin iddiası, e-means'ın ikisini aynı anda iyileştirdiği.
Farklı bir güncelleme kuralı
Proje, mevcut k-means varyantlarını tek bir temanın varyasyonları olarak çerçeveliyor. İncelediği her yöntem, her küme için kendisine atanan noktaların biriken toplamını ve sayısını tutar ve merkezi (centroid) bunların oranı olarak tanımlar. Lloyd algoritmaları bu istatistikleri her geçişte tüm veri kümesi üzerinden sıfırdan yeniden hesaplar; tipik olarak 20 ila 50 iterasyon için. MacQueen'in 1967 güncellemesi bunları süresiz biriktirir; böylece bir merkez, henüz merkezler kötü yerleştirilmişken atanmış noktalar dahil, kendisine hiç atanmış tüm noktaların düzgün ortalaması haline gelir. E-means üçüncü bir yol izliyor: her mini-batch, istatistiklere üstel hareketli ortalama ile harmanlanıyor; böylece eski atamalar α oranıyla soluyor ve merkezler tüm geçmiş yerine güncel veriyi takip ediyor.
Bu tarz güncelleme normalde VQ-VAE'lerdeki codebook öğrenimi gibi hareketli dağılımlar için kullanılır. Projenin bulgusu, yöntemin geri kalanı buna göre tasarlandığında bunun statik veri kümelerinde de son derece etkili olduğu.
Ayar gerektirmiyor, artı son rötuşlar
Batch boyutu ve adım boyutu olmak üzere iki hiperparametre kullanıcıya bırakılmıyor. Bir hiperparametre taraması, bildirildiğine göre en düşük kayıpların çapraz bir bant boyunca uzandığını, yani daha büyük batch'lerin daha büyük adımlar gerektirdiğini gösteriyor; tam batch ve 1 adıma karşılık gelen Lloyd ise bu optimumdan uzakta bir köşede kalıyor. Proje bu taramaya ölçekleme yasaları fit etmiş; böylece e-means her iki değeri de otomatik olarak seçiyor. Yöntem ayrıca adımı α₀'dan cosine takvimiyle onda birine kadar tavlıyor (annealing), yeni bir başlatma ekliyor, ölü kümeleri küçüldüklerinde büyük kümeleri bölerek canlandırıyor ve ihmal edilebilir ek çalışma süresiyle eğitimi her kümenin tam son epok ortalamasıyla tamamlıyor. En yakın merkez atama adımı için birleştirilmiş (fused) GPU kernel'ları, epok tasarrufunu eşdeğer duvar saati kazançlarına dönüştüren şey.
Neden gradient descent değil
Proje, Hugo Touvron ve Hervé Jégou'nun Meta FAIR'deki önceki çalışmasından doğdu; ikili, gradient descent ile optimize edilen mini-batch k-means'in Lloyd'u yenebileceğini bulmuştu. E-means yazarı bu sonuçların yeniden üretilebildiğini, ancak gradient descent güncellemelerinin büyük öğrenme oranlarında kararsızlaşırken hareketli ortalama güncellemelerinin kararsızlaşmadığını söylüyor. Şüphelenilen neden: EMA güncellemesi bir merkezi atanmış noktalarının dışbükey örtüsü içinde tutarken bir gradient adımı onu aşabilir. Her yöntemin en iyi ayarında gradient descent, DEEP veri kümesinde hareketli ortalamanın yüzde 1,6 üzerinde, SIFT'te yüzde 0,4 üzerinde kaldı; EMA varyantına yöntem adını veren de bu.
Dokümantasyon ayrıca e-means'ın, oyuncak veri kümelerinde 200 seed üzerinden yinelenen koşulara dayanarak, yerel minimumlardan Lloyd'dan daha güvenilir şekilde kurtulduğunu bildiriyor.
Uyarılar
Tüm çarpıcı rakamlar projenin kendi web sitesindeki kıyaslamalardan geliyor; bunlar hakem değerlendirmesinden geçmedi ve bağımsız olarak doğrulanmadı. Taban çizgileri de belirli — GPU'da Flash-KMeans, CPU'da Faiss — dolayısıyla bir iş yükünün göreceği hızlanma ölçeğine, boyutluluğuna ve küme sayısına bağlı olacak. Proje sonuçlarının geniş bir ölçek ve veri kümesi aralığında geçerli olduğunu söylüyor, ancak benimseyenler rakamları üçüncü taraflar doğrulayana dek kendi beyanları olarak görmeli.
Neden önemli
K-means pek çok pratik hesaplamanın temelinde yatıyor: embedding nicemleme, model eğitiminden önce veri hazırlama ve daha büyük ML hatları içinde kümeleme. Projenin kendisinin de belirttiği gibi, tam batch optimizasyonunun hâlâ standart olduğu ender makine öğrenmesi sorunlarından biri. Eşit ya da daha iyi kayıpta 10-45 kat hızlanma doğrulanırsa, kümeleme hem GPU hem CPU'da büyük ölçekte çalıştıran iş yükleri için darboğaz olmaktan çıkıyor. Daha geniş ders daha da uzağa gidebilir: modern derin öğrenmeden optimizasyon mekanizmaları — hareketli ortalamalar, öğrenme oranı takvimleri, ölçekleme yasalarından türetilen hiperparametreler — bu muameleyi hiç görmemiş klasik algoritmalara aktarılabilir.
- #machine-learning
- #clustering
- #k-means
- #optimization
- #gpu