· kaynak Hacker News – Front Page (native)
Eğitilmiş 4B model, join ağırlıklı sorgularda Postgres sorgu planlayıcısını yüzde 81 geride bıraktı
Bir geliştirici, supervised tuning ve agentic reinforcement learning ile ince ayar yapılmış 4B açık ağırlıklı bir modelin, 113 join ağırlıklı sorgu üzerinde varsayılan planlayıcıya kıyasla yüzde 44,7 daha düşük gecikmeli Postgres planları üretebildiğini bildiriyor.
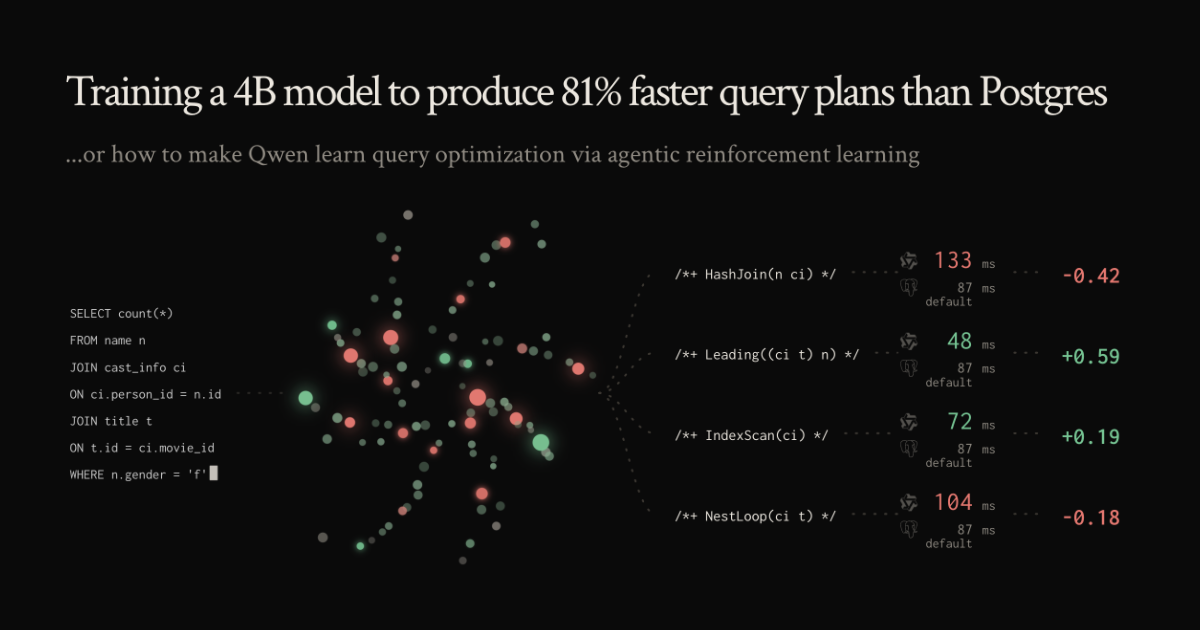
Bir geliştirici, supervised fine-tuning ve agentic reinforcement learning ile post-training uygulanmış 4 milyar parametreli açık ağırlıklı bir modelin, veritabanının kendi planlayıcısından daha iyi performans gösteren Postgres sorgu planları üretebildiğini bildiriyor. Hacker News ana sayfasına ulaşan Rohan Bansal imzalı teknik yazıya göre model, 113 join ağırlıklı sorgu üzerinde yüzde 44,7 gecikme azalması sağladı; yazar bunu, planların Postgres varsayılanlarına kıyasla yaklaşık yüzde 81 daha hızlı çalışması olarak çerçeveliyor.
On yıllık bir eksiklik
Deney rahatsız edici bir bulgudan yola çıkıyor. Leis ve ekibi 2015'te sorgu optimize edicilerinin gerçekte ne kadar iyi olduğunu sorduğunda ve bu soruyu on yıl sonra tekrar gündeme getirdiğinde, yıllarca süren araştırmalara rağmen cevap neredeyse hiç iyileşmemişti. Bansal, bunun kendisini şaşırttığını yazıyor; çünkü bir veritabanı ilke olarak kendi tablolarındaki veriler hakkında her şeyi bilmelidir.
Temel zorluk, formel olarak NP-zor olan join sıralama problemidir. Hangi tabloların hangi sırayla birleştirileceğini seçmenin ötesinde, planlayıcı her join için bir join algoritması (hash, merge veya nested loop), dış ve iç yönelim ile her tablo için bir tarama stratejisi (sequential, index, index-only veya bitmap) belirlemelidir. IMDb veri setinin bir dilimine karşı yapılan tek bir üç tablolu sorgu için Bansal 4.608 farklı plan sayıyor ve bunun, paralel yürütme ile hash'li ve sıralı toplama gibi seçenekleri yok saydığı için eksik bir sayım olduğunu belirtiyor. Postgres bunların tümünü tek tek denemez: arama alanını dinamik programlama ile budar ve on iki veya daha fazla join içeren sorgularda genetik bir algoritmaya geçer.
Planlar nerede yanlışa gidiyor
Bansal, Japon yapım şirketleriyle ilgili bir sorguyla yüksek riskleri gözler önüne seriyor. Filtre koşulu olmadığında, üç tablo için geçerli iki join sırası da aynı iki milyon satırı ikinci join'e besler. Seçici koşullar eklemek her şeyi değiştirir: şirketlerin yaklaşık yüzde 5'i Japonca ise ve başlıkların yüzde 20'si 2000'lerden kalma ise, bir sıralama ikinci join'e yaklaşık 100.000 satır geçirirken alternatif kabaca 400.000 satır geçirir. Bu, özdeş bir cevap için dört kat iş demektir ve daha ucuz yolu seçmek, tek tip veri dağılımı gibi varsayımlara dayanan kardinalite tahminlerine bağlıdır.
Reinforcement learning neden uygun
Yazının merkezindeki gözlem şudur: iyi bir plan üretmek çok zor olsa da bir planı doğrulamak son derece kolaydır; onu çalıştırıp süreyi ölçmek yeterlidir. Tek ve nesnel bir ödül sinyali bulunduğundan, problem daha hızlı planlara yol açan davranışları pekiştirmeye indirgenir; bu, dil modellerinin genellikle iyi performans gösterdiği bir ortamdır.
Eğitim kurulumu
Yazarın listelediği yöntem öne çıkanları şunlardır:
- 113 benchmark sorgusunun 99'u için geçerli bir sorgu planı üretemeyen bir 4B temel modelden başlanması, ancak sonunda set genelinde yüzde 44,7 gecikme azalması elde edilmesi.
- Doğası gereği gürültülü bir ölçüm ortamında reinforcement learning rollout'larını puanlamak için oluşturulmuş özel bir GRPO varyantı.
- Eşzamanlı container'lar arasındaki Linux page cache çekişme gürültüsünü azaltacak şekilde tasarlanmış bir Postgres benchmark düzeneği.
- Kiralanmış bir çift H100 düğümünde çalışan vLLM çıkarımı ve eğitmenle, yazarın kendi masasında çalışan dört Postgres container'ından oluşan iki makineli eğitim bölünmesi.
- Yaklaşık beş yüz GPT-6 Astra ajan yörüngesinden off-policy distillation.
Neden önemli
Sorgu optimizasyonu, veritabanı mühendisliğinin en köklü sorunlarından biridir ve Leis ve ekibinin takip çalışması, geleneksel yaklaşımların bir platoya ulaştığını gösteriyor. Kompakt bir model, olgun ve sınanmış bir planlayıcıdan tutarlı biçimde belirgin biçimde daha iyi planlar seçebiliyorsa, bu, makine öğreniminin veritabanı iç yapılarına yerleşmesi için pratik bir yol işaret eder; çünkü ödülün ölçümü ucuz ve doğruluk yürütmenin kendisi tarafından garanti altına alınmıştır.
Sonuç ayrıca veritabanlarının ötesinde bir şablon sunuyor: nesnel bir puanla ölçülebilen herhangi bir altyapı görevi — indeks seçimi, sorgu yeniden yazımı veya zamanlayıcı ayarı gibi — aynı yaklaşımla ele alınabilir.
Uyarılar geçerli. Değerlendirme 113 join ağırlıklı sorguyu kapsıyor, çalışma hakemli bir araştırma değil tek yazarlı bir deney ve üretime yönelik bir planlayıcının yerini almak, join sıralamasından çok daha fazla SQL yüzeyini ele almayı gerektirirdi. Ancak küçük bir açık modelin, dünyanın en yaygın dağıtılan optimize edicilerinden birinden daha iyi planlamayı öğrenebileceğinin bir gösterimi olarak, bu, yapay zekâ destekli sistem yazılımı için kayda değer bir veri noktası oluşturuyor.
- #postgres
- #reinforcement-learning
- #databases
- #query-optimization
- #machine-learning
İlgili yazılar
- Dream-RSI makalesi, yapay zekâ özkendini geliştirmesini ucuzlatmak için geçmiş keşiflerin yeniden oynatılmasını öneriyor
- Linum'un JiT-DDT'si sıkıştırmayı diffusion modeline katlayarak text-to-image eğitim maliyetini 3,6 kat düşürüyor
- BITCOS, ternary LLM ağırlıklarını 1.58-bit bariyerinin altına indiriyor