· kaynak Hacker News – Front Page (native)
Epoch AI'ye göre sabit bir yapay zekâ performans seviyesinin maliyeti her çeyrekte yüzde 47 düşüyor
Epoch AI, belirli bir yapay zekâ performans seviyesine ulaşma maliyetinin çeyrek başına yaklaşık yüzde 47 düştüğünü tahmin ediyor; eşlik eden bir analiz ise GPU'lar, model mimarileri ve çıkarım (inference) yazılımlarındaki bileşik kazanımları inceliyor.
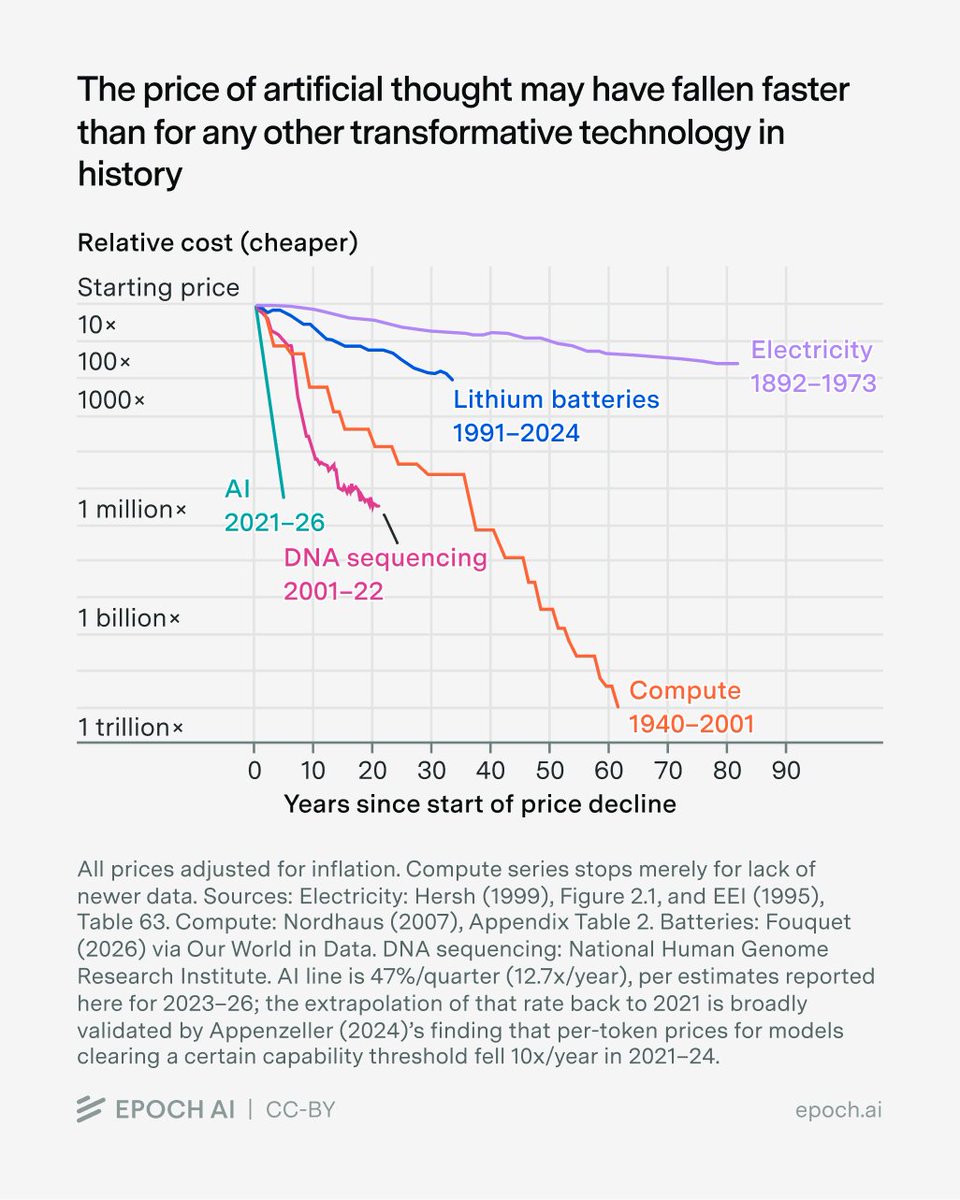
Sabit bir yetenek seviyesi sürekli ucuzluyor
Epoch AI araştırmacıları Emberson ve Roodman, belirli bir yapay zekâ performans seviyesine ulaşma maliyetinin son üç yılda çeyrek başına ortalama yaklaşık yüzde 47 düştüğünü tahmin ediyor. Bileşik olarak bu, yılda kabaca 13 katlık bir düşüş demek; raporu özetleyen Marginal Revolution bu eğimi, önceki dönüştürücü teknolojilerin başardığı her şeyden daha dik olarak nitelendiriyor.
Raporun amiral gemisi örneği şöyle: OpenAI'nin o3 modeli Ocak 2025'te GPQA Diamond benchmark'ında yüzde 75 puan almak için soru başına yaklaşık 0,30 dolara mal olurken, GPT-5.6 Luna 2026 ortasında yaklaşık aynı puanı soru başına yaklaşık 0,0004 dolara aldı. Bu, 18 ayın altında yaklaşık 725 katlık bir düşüş anlamına geliyor.
Marginal Revolution aynı veriden ikinci bir sonuç çıkarıyor: Bu eğri hesaba katıldığında açık ağırlıklı (open-weight) modellerin görünürdeki tehdidi daha küçük görünüyor; çünkü frontier modeller yalnızca eskilerinden daha akıllı olmakla kalmıyor, herhangi bir sabit kalite seviyesinde çalışmaları da çok daha ucuz hale geliyor.
Kazanımların kaynağı
jyn.dev'de yayımlanan ayrı bir teknik analiz, bu deflasyonun gerçek olup olmadığını test etmeyi amaçladı ve tek bir neden yerine birbiri üzerine binen several katmana bağlı olduğunu ortaya koydu.
Donanım tanıdık bir eğri katkısı sağlıyor. GPU güç verimliliği yaklaşık iki yılda bir ikiye katlanıyor; analiz bu hızı 1960'lardaki Moore yasasıyla karşılaştırıyor.
Model ekonomisi daha nüanslı. Frontier modellerin token başına fiyatları tutarlı biçimde düşmüyor, ancak bir görevi bütünüyle tamamlama maliyeti düşüyor; çünkü yeni modeller aynı iş için daha az token, yeniden deneme ve düzeltmeye ihtiyaç duyuyor. Analyzdeki Pareto frontier grafikleri, 2025 ile 2026 arasında kalite ekseninin kabaca sabit kalırken maliyet ekseninin yaklaşık iki büyüklük mertebesi ucuzladığını gösteriyor.
Inference yazılımı göz ardı edilen bir etken. vLLM gibi motorlar 0.5.4 ile 0.11.1 sürümleri arasındaki 15 ayda enerji verimliliğini yaklaşık yüzde 40 iyileştirdi, NVIDIA MLPerf 2.0 ve 2.1 başvuruları arasında yüzde 50'ye varan verimlilik iyileştirmeleri bildirdi ve Intel değişmeyen donanımda MLPerf 6.0 ile 6.1 arasında 2,4 katlık bir iş hacmi artışı gösterdi. Motorlar genelinde analiz yıllık kazanımları yüzde 10 ila 50 arasında konumlandırıyor.
Mimari değişiklikleri geri kalanı bileşik olarak katlıyor. Mixture-of-experts tasarımları, yoğun (dense) bir modelin benchmark performansıyla yaklaşık yedi kat daha az aktif parametreyle eşleşebiliyor (6B'lik bir model, çalışma zamanında 0.8B gibi davranıyor); ancak tüm uzmanlar (expert) bellekte yer almak zorunda olduğundan, barındırılan (hosted) dağıtımlara yerel dağıtımlardan daha çok yardımcı oluyorlar. Mamba ve Mamba-transformer hibrit modelleri her tokenı hatırlamak yerine bağlamı kayıplı bir işleyen özete sıkıştırıyor ve bellek ihtiyacını beş kat veya daha fazla azaltıyor; analiz, Nemotron-H-47B'nin 32 GB VRAM'de bir milyondan fazla token tuttuğuna atıf yapıyor.
Yazılım için anlamı
jyn.dev analizi üç öngörüde bulunuyor: Büyük dil modelleri önümüzdeki bir-iki yıl içinde ürün olarak satılmak yerine altyapı olarak bilgi işlemle iç içe geçecek; bugünkü frontier kalitesindeki modeller üç ila altı yıl içinde sıradan donanımda yerel olarak çalışacak; ve salt token hacmi darboğaz olmaktan çıkarken model kalitesi ve erişim kısıtlayıcı hale gelecek.
Mühendislik ekipleri için pratik sonuç şu: Mimari kararlarına işlenmiş maliyet varsayımlarının artık aylarla ölçülen bir raf ömrü var. Bir zamanlar bir model çağrısını haklı çıkarıp çıkarmadıkları sorusuna bağlı tutulan özellikler, varsayılan olarak etkinleştirilecek kadar ucuzluyor ve karmaşık batching veya caching geçici çözümleri gerekçelerinin büyük kısmını yitiriyor. Analiz bir uyarı ekliyor: Kullanıcılar tasarrufu daha düşük faturalar yerine daha iyi çıktıya harcama eğiliminde, dolayısıyla enerji birimi başına ham token tüketimi kabaca sabit kalırken enerji birimi başına kalite tırmanıyor.
Neden önemli
Sabit bir yeteneğin fiyatındaki yılda kabaca 13 katlık düşüş, planlama sorusunu 'bir ekip inference'ı karşılayabilir mi'den 'hangi kalite katmanı ve erişim yolunun etrafında inşa etmeli'ye dönüştürüyor. Bu aynı zamanda açık ağırlıklı modellerin saf fiyat avantajını zayıflatıyor; çünkü frontier inference fiyatları kendi takvimine göre çöküyor. Ana rakama uygulanırken önemli bir ayrım var: Frontier'de token başına fiyatlar güvenilir biçimde düşmüyor, dolayısıyla en gelişmiş modellere bağlı ürünler rahatlamayı tekdüze ucuzlayan tokenlar yerine daha ucuz görevler ve daha ucuz yetenek seviyeleri üzerinden görecek.
- #ai
- #llm
- #inference
- #cost-trends
- #machine-learning
İlgili yazılar
- Jev demistifiye edildi: teknik analizler, hype yapılan 'System One' modelinin özünde bir classifier olduğunu savunuyor
- Opus 5.5'in daha ucuz cache okumaları bir geliştiricinin text-to-SQL maliyet hesabını alt üst ediyor
- 110 açık kaynak yapay zeka kullanım ölçümleme aracının denetiminde 45'ten fazla faturalandırma hatası bulundu