· kaynak Hacker News – Front Page (hnrss.org)
Gemini 4 Neon, Models Engineering Index'te zirveye yerleşti
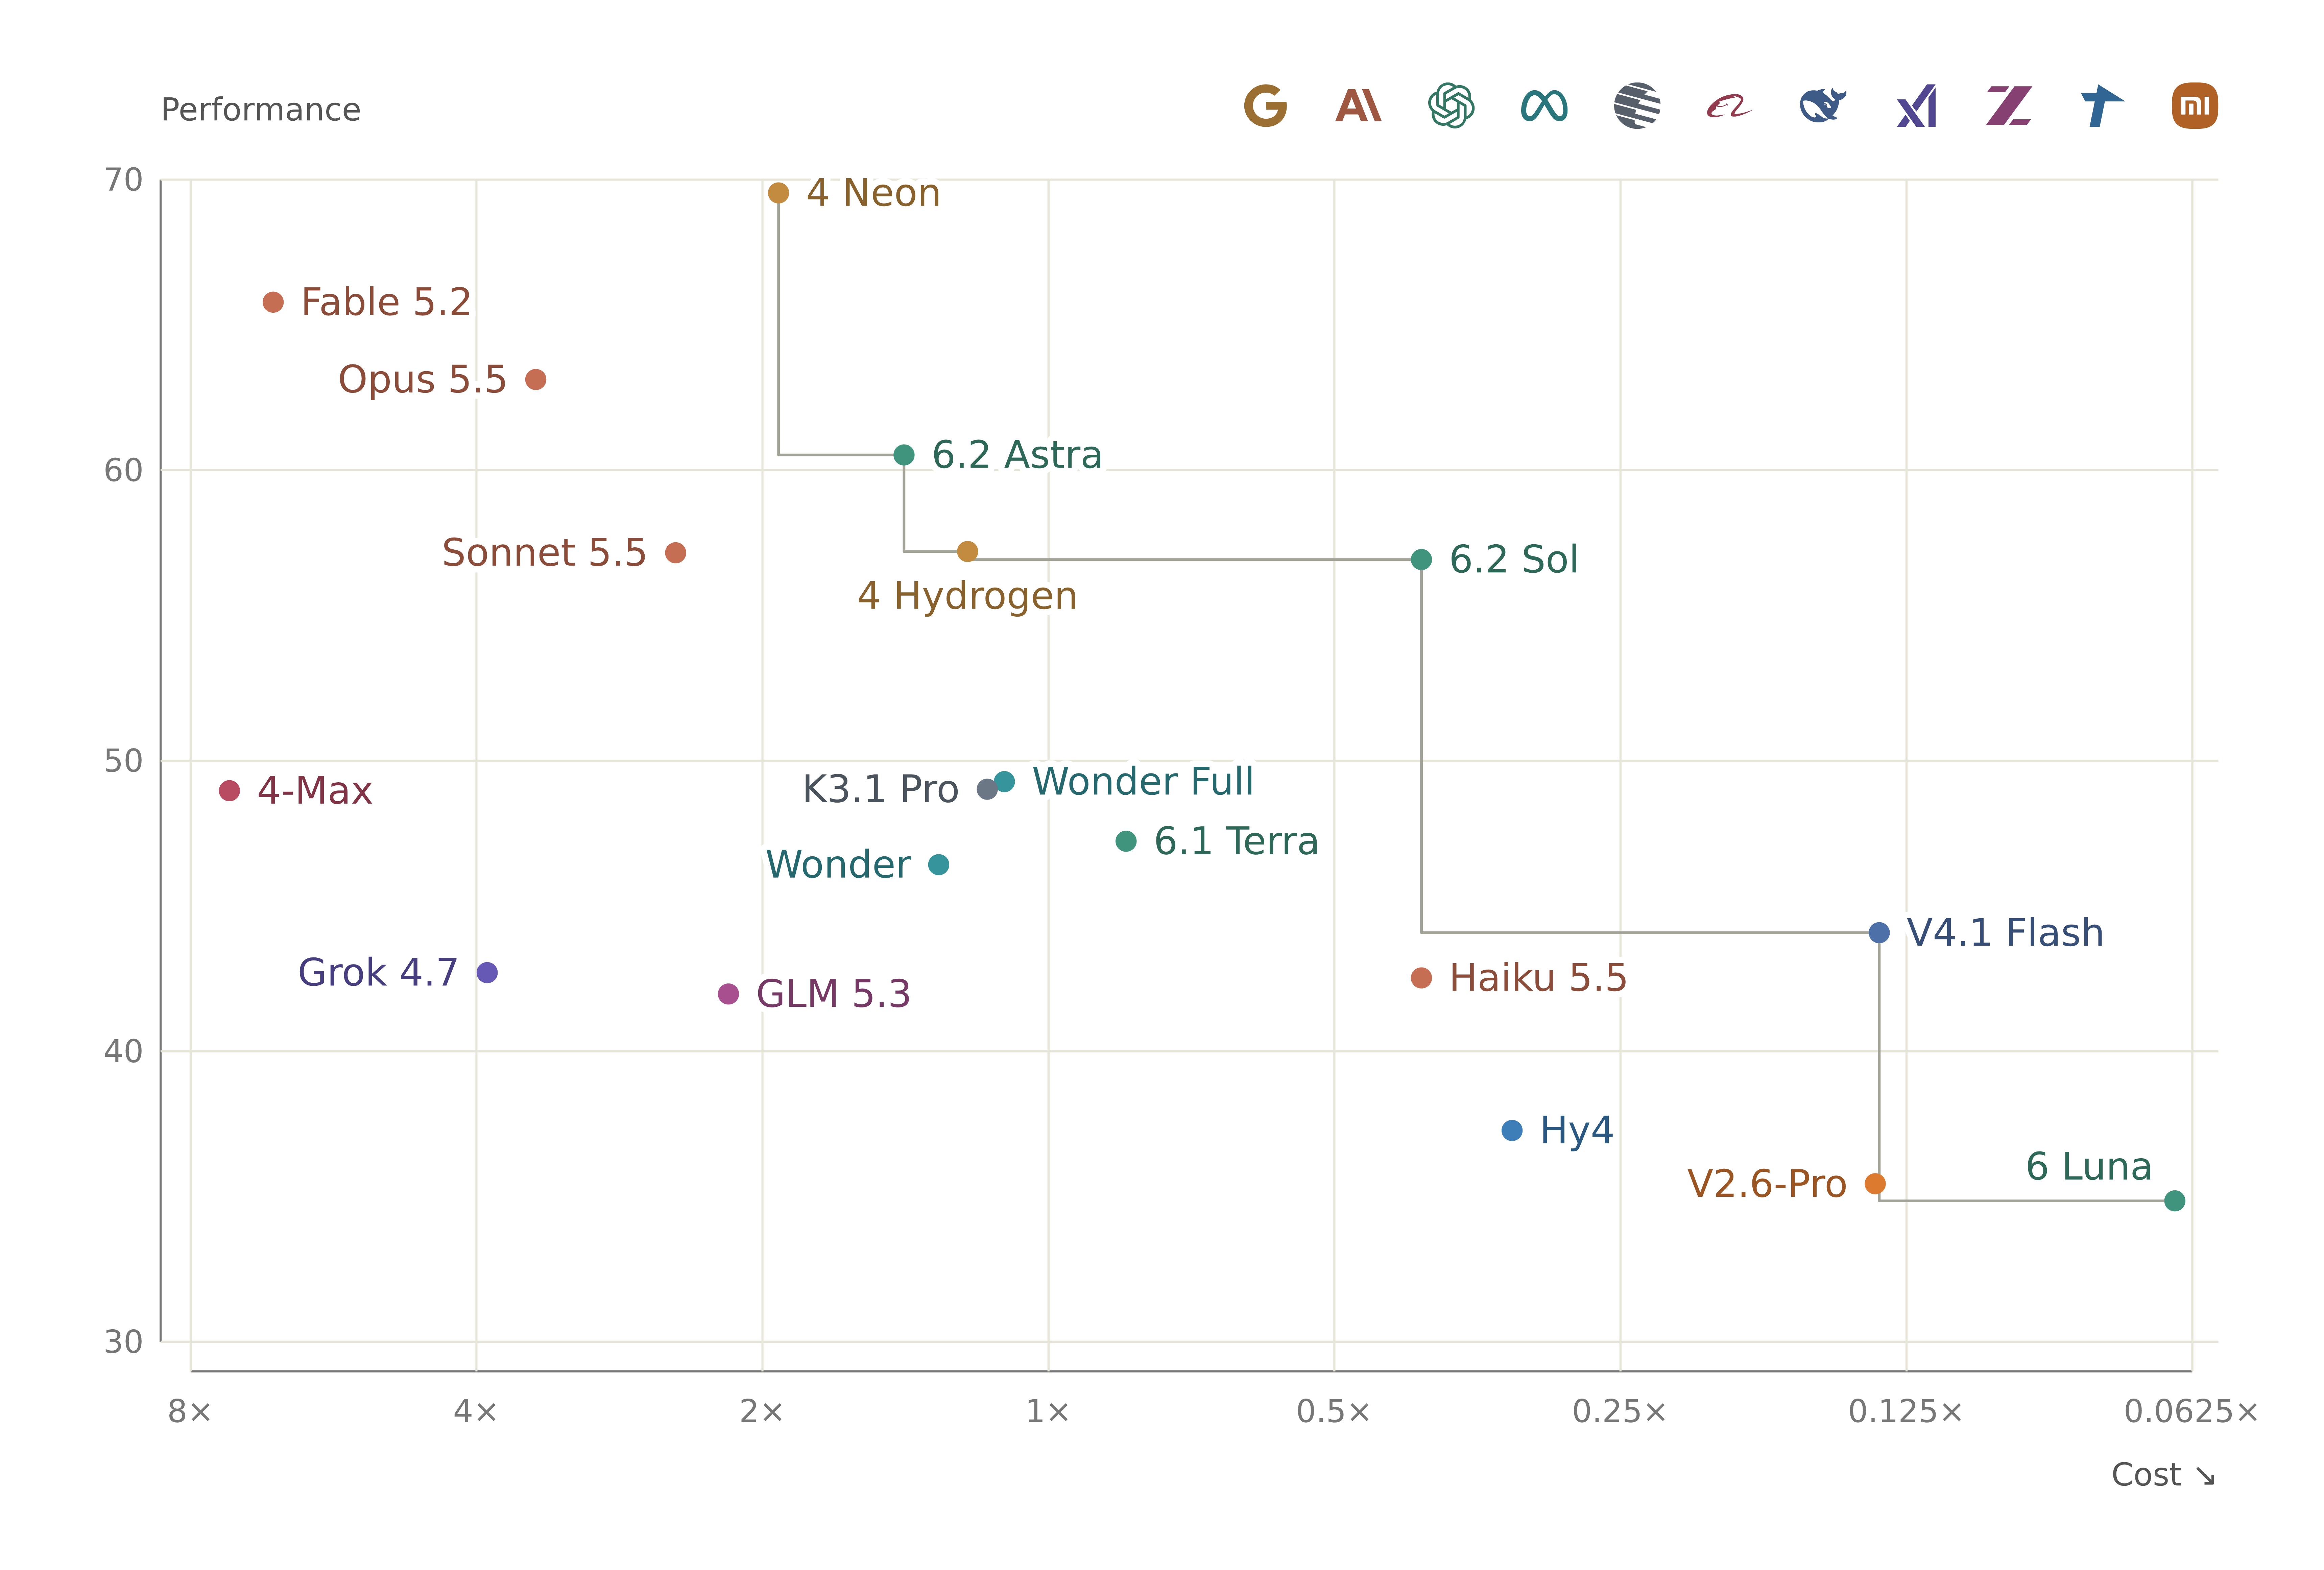
Google'ın Gemini 4 Neon'u, Models Engineering Index'te 69.5 puanla birinci sıraya yerleşti; Anthropic'in Fable 5.2'sini geride bırakırken, index'in fiyat karşılaştırmasında çok daha düşük bir maliyet çarpanı taşıyor.
Gemini 4 Neon, Models Engineering Index'in lideri
Google'ın Gemini 4 Neon'u, dil modellerinin gerçek mühendislik işlerini ne kadar iyi yönettiğini puanlayan bağımsız bir sıralama olan Models Engineering Index'te (Mei) zirveye yerleşti. En son güncellemesi Hacker News'in ana sayfasında öne çıkan index'e göre Neon, 69.5 puan aldı; Anthropic'in Fable 5.2'si 65.8 ve Opus 5.5'i 63.1 puanla geride bıraktı.
Mei sonuçlarını üç eksende — performans, maliyet ve token kullanımı — sunuyor ve ziyaretçilerin iki modeli, CursorBench, FrontierCode, Code Migration, IOI, ProgramBench, Terminal-Bench ve Vibe Code gibi mühendislik odaklı benchmark'lar üzerinden karşılaştırmasına izin veriyor.
Tablonun zirvesi nasıl görünüyor
İlk üçün ardından OpenAI'nin 6.2 Astra'sı 60.5 puanla dördüncü sırada. Google, ilk beşe ikinci bir model daha soktu: Gemini 4 Hydrogen 57.2 puanla Anthropic'in Sonnet 5.5'iyle aynı puanda; index, Sonnet'i bir basamak aşağıda altıncı listede gösteriyor. OpenAI'nin 6.2 Sol'u 56.9 puanla onu takip ediyor.
İlk onun kalanını bir grup rakip dolduruyor: Meta'nın Wonder Full'u 49.3, Moonshot'un K3.1 Pro'su 49.0, Alibaba'nın 4-Max'ı 49.0 ve OpenAI'nin 6.1 Terra'sı 47.2 puanla. Meta'nın daha küçük Wonder modeli 46.4 puanla on ikinci sırada. Daha aşağılarda DeepSeek'in V4.1 Flash'ı 44.1'e ulaşıyor, xAI'nin Grok 4.7'si 42.7 ve Anthropic'in Haiku 5.5'i 42.5 puan alıyor; Z.ai'nin GLM 5.3'ü 42.0 puanla hemen ardından geliyor. Tencent'in Hy4'ü (37.3), Xiaomi'nin V2.6-Pro'su (35.4) ve OpenAI'nin 6 Luna'sı (34.8) on dokuz modellik tabloyu tamamlıyor.
Maliyet işin yarısı
Index her puanı göreli maliyet ve token çarpanlarıyla eşleştiriyor ve Neon'un liderliği tam da burada dikkat çekici hale geliyor. Neon, maliyet çarpanı 1.9× ve token kullanımı 1× olarak listelenirken; ikinci sıradaki Fable 5.2, 6.5× maliyet çarpanı ve 2.1× token kullanımı taşıyor. Opus 5.5 ise 3.5× maliyette bulunuyor. Tablonun zirvesindeki model, tablodaki en pahalı model değil — bu ayrım, genel sıralamada onuncu olan Alibaba'nın 7.3×'lik 4-Max'ına ait.
Daha ucuz seçenekler fiyat-performans açısından rekabetçi kalmayı sürdürüyor. OpenAI'nin 6.2 Sol'u 0.4× maliyetle 56.9 puan alıyor ve DeepSeek'in V4.1 Flash'ı 0.13× maliyetle 44.1'e ulaşıyor. Fiyat aralığının en dibindeyse OpenAI'nin 6 Luna'sı 0.065× maliyetle 34.8 puan alıyor.
Neden önemli
Kodlama ve mühendislik görevleri için model seçen geliştiriciler açısından Mei'nin en üstteki sonucu, bir performans sinyali olduğu kadar bir fiyat-performans sinyali. Index'in en yüksek puanlı modeli premium değil orta fiyatlı ve token kullanımı 1× seviyesinde gösterilirken, daha düşük puanlı bir rakip üç kattan fazla maliyete sahip. Bu kombinasyon — mühendislik performansında liderlik maliyet liderliğiyle birleşmeden — varsayılan kodlama modeli arayan ekiplerin tam da aradığı şey.
Her zamanki uyarılar geçerli. Bu yerleşik bir standart değil, tek bir bağımsız index; kamuya açık sayfa sınırlı metodolojik ayrıntı sunuyor ve tek bir benchmark ailesindeki sıralamalar rutin biçimde diğerlerinden sapıyor. Ama güncel piyasanın bir fotoğrafı olarak tablo tanıdık: Anthropic modelleri ham puan olarak hemen arkada, Google zirvede fiyat-performans liderliğini elinde tutuyor, OpenAI'nin daha ucuz varyantları fiyat-performansla yarışıyor ve Moonshot, DeepSeek ile Alibaba'nın uzman rakipleri 50 puan çizgisinin altında kümeleniyor. Kabiliyetler öndeeki pakette yakınsıyor ve fiyat giderek belirleyici fark haline geliyor.
- #gemini
- #llm-benchmarks
- #anthropic
- #ai-models