· kaynak Hacker News – Front Page (native)
İnce ayarlanmış 360M'lık model, arkasında shell olmadan tüm bir terminali simüle ediyor
Bir geliştirici, 360M parametreli bir Qwen modeline arkasında shell olmadan tam bir terminal gibi davranmayı öğretti; model her tuş vuruşundan ekran değişimini tahmin ediyor. 208 MB'lık bir WebGPU tarayıcı demosu olarak çalışıyor.
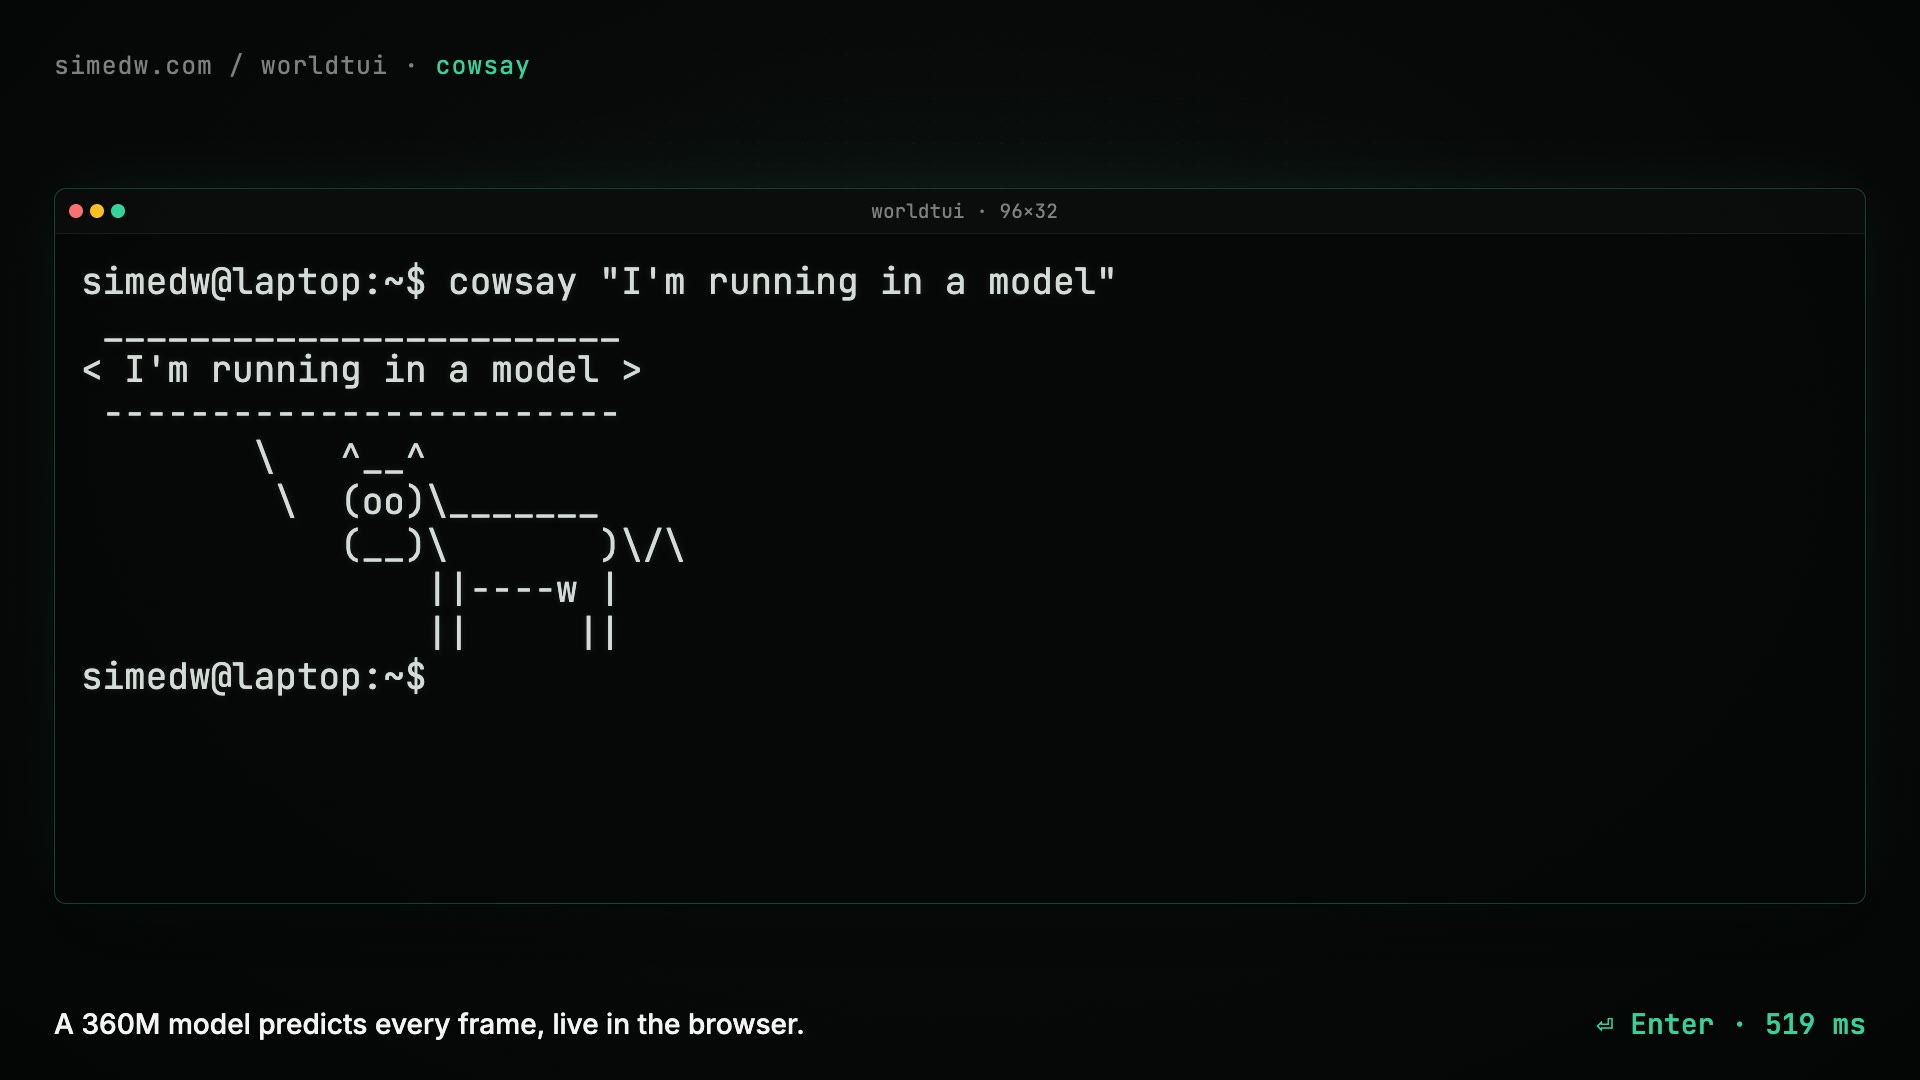
Altında shell olmayan bir terminal
simedw adıyla paylaşımda bulunan bir geliştirici, 360M parametreli bir dil modeline tam bir terminal gibi davranacak şekilde ince ayar yaptı; yazısı Hacker News'in ana sayfasına kadar yükseldi. Arka planda gerçekten hiçbir şey çalışmıyor: her tuş vuruşu modele ham baytlar olarak veriliyor ve model, ekrandaki karakter ızgarasının buna nasıl tepki olarak değişeceğini tahmin ediyor. Gönderiye göre dosya oluşturabiliyor, vim ve tmux çalıştırabiliyor, snake oynayabiliyor ve genellikle birkaç komut önce yazılan metni hatırlayabiliyor.
Proje, Genie 3 tarzında bir "dünya modeli" denemesinin küçültülmüş bir hali olarak başladı; bu yaklaşımda render işini bir motor değil, model kullanıcı girdisinden sıradaki ne olacağını tahmin ediyor. Terminal bu hedefe çok uygundu: piksellerden değil bir karakter ızgarasından oluşuyor ve gerçek shell'lerin kaydı fiilen sınırsız ve kusursuz etiketlenmiş eğitim verisi üretiyor.
Model ekranı nasıl görüyor
Sıradan LLM'ler prompt'un sonuna token ekler; bu, terminallere kötü eşleşir. Tek başına bir Escape tuşu vim'de bir şey yapar ve clear komutu en alta yazdırmak yerine en baştan yeniden çizer. Bu yüzden model metin akışları yerine ekran değişimlerini tahmin ediyor.
Her oturum, ekran boyutlarını, içeriğini ve imleci tanımlayan bir anlık görüntüyle açılıyor; oturumlar bir uygulamanın ortasında başlayabiliyor — bir bash prompt'undan, bir vim tamponundan veya devam eden bir oyundan. Her tuş vuruşu, gerçek bir terminalin göndereceği baytlar olarak geliyor ve model de yeniden yazılacak satırlarla son imleç konumunu, imlecin görünür olup olmadığı bilgisini de içeren bir bayrakla yanıtlıyor. Zaman da modelleniyor: süre bilgisini taşıyan bir WAIT token'ı, kimse yazmazken snake'in hareket etmesini sağlıyor.
Kaydırma, saf bir yaklaşımın patladığı yer — her satırı yukarı kaydırmak tek bir Enter için yaklaşık 3.000 token'a mal olabiliyor. Bunun yerine bir COPY işlemi satırları satır başına üç token karşılığında önceki ekrandan ileri çekiyor ve aynı mekanizma temizlenmiş ekranları, vim satır düzenlemelerini ve man sayfası gezinmesini de kapsıyor. Tüm sözlük 333 token: karakterler ve küçük sayılar için yeniden kullanılan, Qwen'un zaten sahip olduğu 256 bayt token'ı, artı 64 satır token'ı ve birkaç işlem. Kod çözme gramer kısıtlı, yani her tahmin geçerli bir ekran güncellemesi oluyor.
Sentetik veri ve kendini onarma eğitimi
Yazar, tam tuş vuruşu-ekran hizası içeren hazır bir külliyat bulamadı (asciinema kayıtları dahil); bu yüzden eğitim verisi, gerçek komutlar Docker container'larında çalıştırılarak ve her tuş vuruşuyla sonuçtaki ekran kaydedilerek üretildi. Kullanıcı adları, hostname'ler, prompt stilleri, terminal boyutları ve dosya düzenleri kurgusal kişiler çevresinde rastgelelendirildi; her oturum 6–24 ağırlıklı etkinlik seçti; yazmaya tab tamamlama ve yüzde 1,2'lik yazım hatası oranı dahildi. Oturumların yaklaşık yüzde 35'i ortasında bir yerden başlıyor. Bitmiş veri kümesi 336k bölüm, kabaca 2B token içeriyor — temel modelin ön eğitim sırasında gördüğü yaklaşık 18T'nin yanında bir kırıntı.
Temel model, gerçek zamanlı çıktıya yakın olmanın önemli olmasından ve komut satırı kullanımına önceden aşina olmasından dolayı küçük boyutuyla seçilen Qwen2.5-Coder-0.5B. Düz supervized fine-tuning yazmayı hızla öğrendi, ama hatalar uzun oturumlarda birikti; tek bir yanlış dosya adı sonrasındaki her şeyi kirletti.
Çare DAgger'dan ödünç alınıyor: model yalnızca ideal gösterimler üzerinde değil, modelin gerçekten ulaştığı durumlar üzerinde eğitiliyor. Kayıtlı oturumların örneklenmiş noktalarında model sonraki birkaç olayı tahmin ediyor, ekranı gerçek ekranla karşılaştırılıyor ve bir sonraki tuş vuruşunda modelin ekranını onaran bir düzeltme oluşturuluyor. Kritik nokta şu: bir düzeltme yalnızca önceki gerçek ekranlarda veya kullanıcının kendi yazdığında görünmüş bilgiler içerebilir — modelin çıkaramayacağı düzeltmelerle eğitim halüsinasyonu ödüllendirmek olurdu. Örneklenen oturumların yaklaşık üçte biri kullanılabilir düzeltmeler üretti; üç tur boyunca, ek verilerle birlikte bu, yazarın PresetBench adını verdiği bir benchmark'ı int4'te 24/47'den 38/47'ye çıkardı ve kendini düzeltme, en etkili eğitim değişikliklerinden biri hâline geldi.
Kendiniz çalıştırmak
Demo, WebGPU'lu bir masaüstü tarayıcı ve fiziksel klavye için tasarlanmış 208 MB'lık bir indirme; Chrome veya Edge öneriliyor; modern bir telefonda çalışıyor ama yavaş. Yazarın önerdiği akıl kontrolü "pythoon" yazmak — yanlış yazılmış bu komut, ortada gerçek bir shell olmadığını açıkça gösteriyor.
Neden önemli
Bu, küçük bir modelin yalnızca ikna edici terminal biçimli çıktı üretmek yerine tutarlı bir dünya sürdürebileceğinin kompakt ve tekrarlanabilir bir kanıtı. Bileşenler — tahmin hedefi olarak ekran deltaları, gramer kısıtlı kod çözme, kaydırma için ucuz bir COPY kodlaması ve DAgger tarzı kendini onarma eğitimi — terminallerin ötesine, durum artı güncellemeler olarak ifade edilebilen her arayüze iyi aktarılıyor. Ayrıca ajan araştırmalarına bağlanıyor: bir ortamı sadakatle simüle eden model hafif bir sandbox veya veri üreteci olarak hizmet edebilir. Ve bir tarayıcı sekmesinde çalışan 360M parametreyle, öğrenilmiş ve simüle edilmiş yazılımın sınır ölçeğinde hesaplama gücü gerektirmeyebileceğini ima ediyor.
- #machine-learning
- #language-models
- #fine-tuning
- #terminal
- #qwen
İlgili yazılar
- Reward AI'nın OM-1'i, yeni robot görevleri için 30 dakikadan az insan hareket verisi gerektirdiğini iddia ediyor
- Baseten'in Mammoth-1 ve Elephant-1 karar modelleri 27 Ekim'e kadar Vercel AI Gateway'de ücretsiz
- Recursive, büyük ölçüde yapay zekâyla geliştirilen, ücretsiz ve laptoplarda çalışan Flint kodlama modelini duyurdu