· kaynak Hacker News – Front Page (hnrss.org)
llama.cpp'de prompt lookup drafting 42 kat hızlandı, Lemire'nin pull request'i ile 140 kata çıkıyor
Hayder Tirmazi, daha yalın n-gram cache'leri sayesinde llama.cpp'deki prompt lookup drafting gecikmesini 42 kata kadar düşürdü; Daniel Lemire'nin ardından gelen pull request'i ise toplam hızlanmayı 140 kata taşıyor.
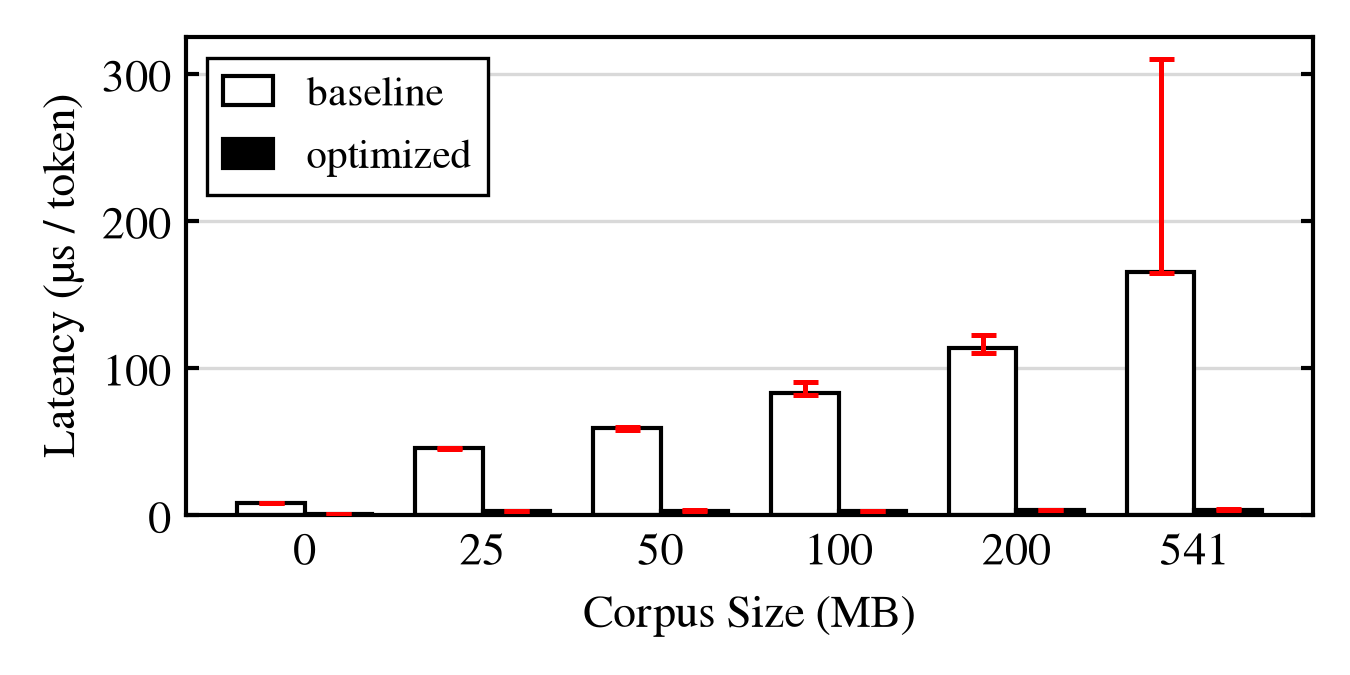
42 katlık hızlanma, şimdi üst üste binerek 140 kata çıktı
26 Eylül'de yayımlanan bir blog yazısında Hayder Tirmazi, llama.cpp'deki prompt lookup drafting'i 42 kata kadar hızlandırırken 2,6 kata kadar daha az bellek kullanan bir dizi değişikliği anlatıyor. Optimizasyonlar, Daniel Lemire ve Martin Ankerl'ın önceki performans çalışmalarına dayanıyor ve llama.cpp'nin n-gram cache'lerinin ardındaki veri yapılarına odaklanıyor. Yayımın ardından Lemire, ek bir 4,2 katlık hızlanma sağlayan bir pull request gönderdi; Tirmazi'ye göre bu, toplam iyileşmeyi 140 kata kadar çıkarıyor. Yazı, Hacker News ana sayfasına ulaştı.
Prompt lookup decoding ne yapar
Prompt lookup decoding, n-gram spekülasyonu olarak da bilinir, speculative decoding'in yalınlaştırılmış bir biçimidir. Ana modelin doğrulaması için token taslağı hazırlamak amacıyla ikinci bir sinir ağı çalıştırmak yerine bir n-gram modeli kullanır: önceki n token verildiğinde, bir corpus'ta bu diziyi en sık izleyen token'ı tahmin eder. llama.cpp, vllm ve Hugging Face'in transformers kütüphanesi bu tekniğin tümünü destekler.
llama.cpp bunun için üç cache tutar. Context cache, o anda işlenen token'lardan uzunluğu 1 ila 4 arasındaki n-gram'ları saklar ve üretim ilerledikçe güncellenir. Dynamic cache, önceki oturumlar gibi daha önceki çalışmalardan sayıları biriktirir. Static cache ise llama-lookup-create aracıyla oluşturulmuş çevrimdışı bir metin corpus'undan 2-gram'ları tutar.
Taslak hazırlarken llama.cpp bu sırayla n = 4, 3, 2 ve 1 değerlerini dener; her bir kelime dağarcığı token'ını, context veya dynamic cache'te önceki n token'ı kaç kez izlediğine göre puanlar; ayrıca static cache ile uyuşan adaylara büyük bir ağırlık bonusu verilir. Bir token yalnızca n-gram en az belirli bir minimum sayıda görülmüşse ve token bu oluşumların en az belirli bir oranında onu izlemişse taslak olarak önerilir; b11182 sürümü itibarıyla bu eşikler kod içine sabit olarak gömülüdür. Dynamic cache'e yalnızca hiçbir n değerinde context cache geçerli bir aday üretmediğinde başvurulur; ikisi de başarısız olursa llama.cpp yalnızca static cache'e geri döner.
Darboğaz neredeydi
Tirmazi'ye göre cache'ler iç içe C++ std::unordered_map örneklerinden oluşuyordu: dıştaki map n-gram'a göre anahtarlanıyor, içindeki map'ler her bir izleyen token'ı sayısına eşliyordu. İlk düzeltmesi basitçe içteki map'lerin kopyalanmasını durdurmak oldu; bunu bir optimizasyondan çok hata düzeltmesine yakın bir sorun olarak nitelendiriyor. Çalışmanın geri kalanı, Lemire ve Ankerl'ın önceki performans mühendisliğinden alınan teknikleri uyguluyor. Değişikliklerin hiçbiri taslak algoritmasını kendisini değiştirmediğinden, token kabul oranları özgün uygulamayla fiilen aynı kalıyor; iyileşen şey, taslağı hazırlanan token başına gecikme, static cache yükleme süresi ve static cache'in bellek ayak izi.
Nasıl ölçüldü
Tirmazi kıyaslamaları llama.cpp'nin kendi örnek araçlarıyla yaptı: WikiText-103'ten static cache oluşturmak için llama-lookup-create ve bir dosyanın token'larını simüle edilmiş model çıktısı olarak yeniden oynatıp kaç taslak token'ın eşleştiğini, taslak hazırlamanın ne kadar sürdüğünü ve static cache'in yüklenmesinin ne kadar sürdüğünü kaydeden llama-lookup-stats. Tam 541 MB'lık corpus'un yanı sıra 25, 50, 100 ve 200 MB'lık alt kümelerini ve yalnızca context ile dynamic cache'leri ölçen sıfır-corpus yapılandırmasını test etti. Tüm rakamlar üç koşunun ortancası olup en düşük ve en yüksek değerler de gösterilmiştir; model context'i 4.096 token varsayılmıştır. Donanım, 14 çekirdekli ve 48 GB bellekli bir Apple M4 Pro idi. Değerlendirme yöntemi, static n-gram cache'ini ilk olarak llama.cpp'ye ekleyen JohannesGaessler'ın pull request'ini izliyor ve Tirmazi kodunu ile sonuçlarını eşlik eden bir depoda yayımladı.
Neden önemli
Speculative decoding, modelin kendisini değiştirmeden otoregresif üretimi hızlandırmanın birkaç yolundan biri; prompt lookup ise ek ağırlık gerektirmediği için en ucuz varyantı ve llama.cpp'nin yaşadığı yer olan yerel çıkarım için biçilmiş kaftan. Ancak taslak adımı kritik yolun üzerindedir: n-gram aramaları yavaşsa ya da static cache'i yüklemek ve tutmak pahalıysa, teknik kazandırdığının büyük kısmını geri verir. Taslak gecikmesini 42 kata kadar, Lemire'nin devam work'u ile bildirildiği üzere 140 kata kadar düşürmek, kuramsal hızlanmanın daha fazlasının kullanıcıya kadar ulaşması anlamına gelirken, 2,6 katlık bellek azaltımı da RAM'in model ağırlıkları, KV cache ve olası spekülatif mekanizmalar arasında paylaşıldığı makinelerde yer açar. Bu olay ayrıca, olgun çıkarım motorlarında düz veri yapısı mühendisliğinin — iç içe map'leri değiştirmenin ve gereksiz kopyaları ortadan kaldırmanın — hâlâ on kat mertebesinde kazanımlar sağlayabileceğini ve açık kaynak iş birliğinin bir blog yazısı yayımlandıktan kısa süre sonra bunları katlayabileceğinin de bir hatırlatıcısıdır.
- #llama-cpp
- #speculative-decoding
- #performance
- #local-inference
- #cpp