· kaynak Hacker News – Front Page (hnrss.org)
pgrust v0.4-beta, Gravity sorgu motoruyla geliyor; ClickBench'te ClickHouse'tan 3 kat hızlı olduğunu iddia ediyor
pgrust, v0.4-beta ile birlikte yayınlanan yeni Gravity sorgu motorunun ClickBench benchmark'ını tam Postgres SQL desteğini korurken ClickHouse'tan 3 kata kadar daha hızlı çalıştırdığını, SQL'i makine koduna JIT derleyerek söylüyor.
pgrust v0.4-beta, Gravity sorgu motorunu tanıtıyor
Kolonlu depolamaya sahip, Postgres uyumlu analitik motor pgrust'ın geliştiricileri, yeni bir sorgu motoru olan Gravity'yi tanıtan v0.4-beta sürümünü yayınladı. Hacker News'in ana sayfasına düşen şirket blog yazısına göre Gravity, ClickBench benchmark'ını, benchmark'ın tam da tanıtmak için yaratıldığı sistem olan ClickHouse'tan üç kata kadar daha hızlı çalıştırıyor; üstelik tam Postgres SQL diyalektini ve tip sistemini de destekliyor. Rakamlar bağımsız denetimden geçmiş değil, doğrudan üreticinin kendisine ait; ancak arkasındaki mühendislik stratejisi net: her SQL sorgusunu çalışma zamanında makine koduna derlemek.
Copy-and-patch'ten gerçek bir derleyiciye
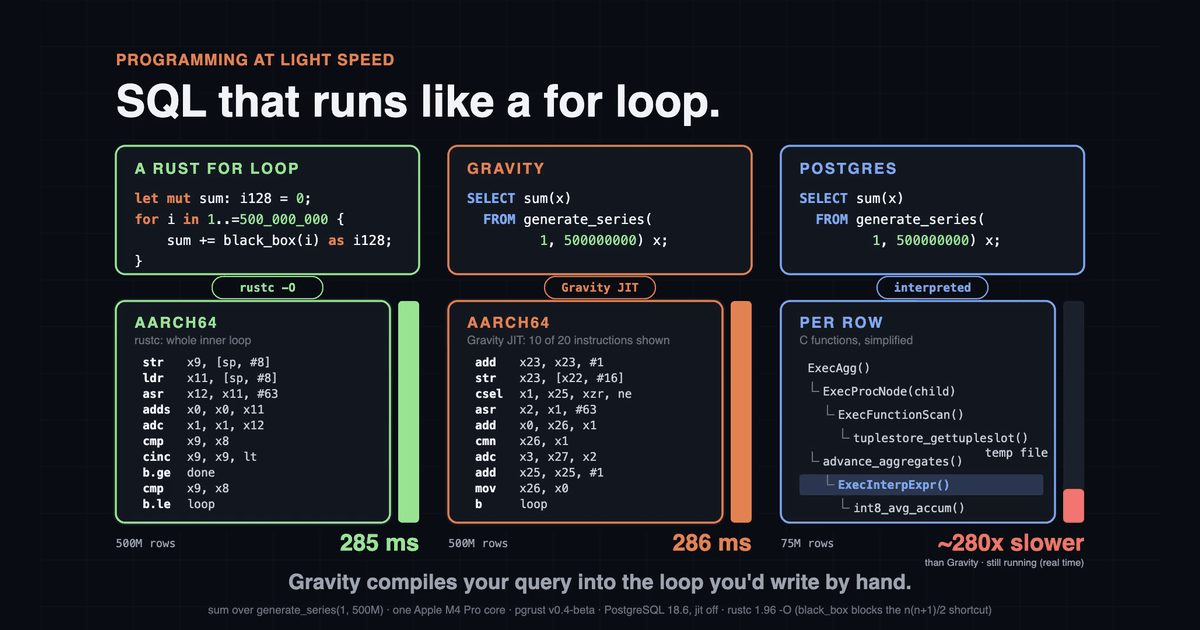
Gravity, pgrust'ın önceki yazılarında anlattığı çalışmanın üzerine inşa ediliyor: batching, operator fusion ve SIMD, analitik sorguları Postgres'in hızının yüzlerce katına çıkarmıştı; copy-and-patch JIT ise önceden derlenmiş şablonları beş mikrosaniyede birleştiriyordu. Yazarlara göre şablonları birbirine yapıştırmak bir tavana çarpıyor. Gerçek bir ara temsil (intermediate representation) ve tüm bir döngüyü kapsayan register allocation olmadan, üretilen kod rustc veya Clang gibi bir optimize edici derleyicinin üretebileceği düzeye ulaşamıyor. v0.4 için bu açığı, herhangi bir SQL sorgusu için özel makine kodu üreten bir derleyiciyle kapatmayı hedeflediler.
Yapay zekayla hız sınırını belirlemek
Yaklaşımları alışılmış optimizasyon döngüsünü tersine çevirdi. Hotspot'ları profilleyip her seferinde yüzde 15-20 kazanç sağlamak yerine, donanım ve dosya formatının fiziksel olarak izin verdiği en hızlı yürütmeyi belirlemeye ve oradan geriye doğru çalışmaya çalıştılar — buna "ışık hızında programlama" diyorlar.
Bu tavanı ölçmek için Claude adlı yapay zeka modelinden, analitik sorgulardan oluşan bir küme için bağımsız, yoğun biçimde optimize edilmiş Rust programları yazmasını istediler. Bu programlar SQL yürütücüsünü tamamen atlıyor, el yazımı çok iş parçacıklı döngülerle SIMD'yi doğrudan pgrust'ın diskteki formatına karşı çalıştırıyordu. Yazıya göre bu programlar, sorgu kümesi genelinde tutarlı biçimde ClickHouse gibi yerleşik analitik veritabanlarından yaklaşık dört kat daha hızlıydı. Ekip ardından bu programlardan optimizasyonları çıkardı ve Gravity'ye somut bir hedef koydu: herhangi bir SQL sorgusu için, el yazımı referansın yüzde 20'si içinde kalan çalışma zamanı kodunu JIT ile derlemek.
SQL'i assembly'ye indirmek
Gravity, Postgres'in parser ve planner bileşenlerini yerinde bırakıyor; pgrust planner hâlâ tablo istatistiklerine bakıyor ve standart bir sorgu planı üretiyor. Çok aşamalı bir derleyici bu planı adım adım indiriyor: verinin nasıl aktığını tanımlayan bir pipeline grafiğine, assembly'ye benzeyen Lisp tabanlı bir ara temsile ve son olarak hedef başına backend'ler aracılığıyla assembly'ye.
Yazıdaki örnek olayda — LIKE filtresi uygulanan bir hits tablosu üzerinde gruplanmış toplama, count'a göre sıralı ve on satırla sınırlı — pipeline grafiği yürütmeyi üç pipeline'a bölüyor. İlki satırları tarıyor, filtreyi uyguluyor ve bir hash aggregate oluşturuyor; ikincisi sonuçları top-k için onluk bir heap'e itiyor; üçüncüsü kazanan satırları iletişim hattına (wire) projekte ediyor.
Her pipeline, Lisp IR içinde tek bir fonksiyona derleniyor ve derin fusion'ı mümkün kılan da tam olarak bu: tarama, filtre, projeksiyon ve toplama tek bir döngüde birleşiyor. Ek açıklamalı IR bunun ne kazandırdığını gösteriyor. URL filtresi tek bir bit testine dönüşüyor, çünkü kolon dictionary-encoded; timestamp'tan dakika çıkarmak bölme yerine multiply-and-shift aritmetiği kullanıyor; ve aktif grubun anahtarları register'larda kalıyor, hash tablosuna yalnızca bir satırın anahtarları eşleşmediğinde dokunuluyor.
Neden önemli
Bu lansman öncelikle ortadan kaldırdığını iddia ettiği şeyle dikkat çekiyor: analitik hız ile Postgres uyumluluğu arasındaki klasik ödünleşim. Ekipler ya Postgres'i tutup yavaş analitiği kabul ediyor, ya da iş yüklerini ClickHouse gibi kolonlu depolara taşıyıp Postgres SQL'den ve ekosisteminden vazgeçiyordu. pgrust'ın rakamları bağımsız testlerden geçerse, Gravity ClickBench sınıfı performansla tam Postgres diyalektinin bir arada var olabileceğinin kanıtı olur.
Metodoloji kendi başına dikkati hak ediyor. El ile ayarlanmış referans uygulamalar üretmek için bir yapay zeka modeli kullanmak, bunları ölçülebilir bir performans tavanı olarak ele almak ve ardından bir derleyiciden bu açığı kapatmasını istemek, performans odaklı başka projelerin de benimseyebileceği bir iş akışı — ve yapay zeka tarafından yazılan kodun bir prototip değil, sevk edilen bir sistemi şekillendirmesinin somut bir örneği.
Yine de uyarılar gerçek: bu bir 0.4 beta, benchmark sonuçları kendi beyanlarına dayanıyor ve ClickBench karşılaştırmalarının uzun bir metodolojik tartışma geçmişi var. Standart donanımda bağımsız tekrarlama, sıradaki önemli test bu olacak.
- #databases
- #postgres
- #rust
- #query-engine
- #benchmarks
- #simd