· kaynak Hacker News – Front Page (native)
Platypush sesli asistan yenilemesi microWakeWord'ü Silero VAD ve OpenAI pluginleriyle buluşturuyor
Platypush blog yazısında sesli asistanın baştan aşağı yenilendiği anlatılıyor: uyandırma kelimesi için microWakeWord, konuşma sınırları için Silero VAD, transkripsiyon, yanıtlar ve TTS için OpenAI pluginleri; her aşamada yerel alternatifler mevcut.
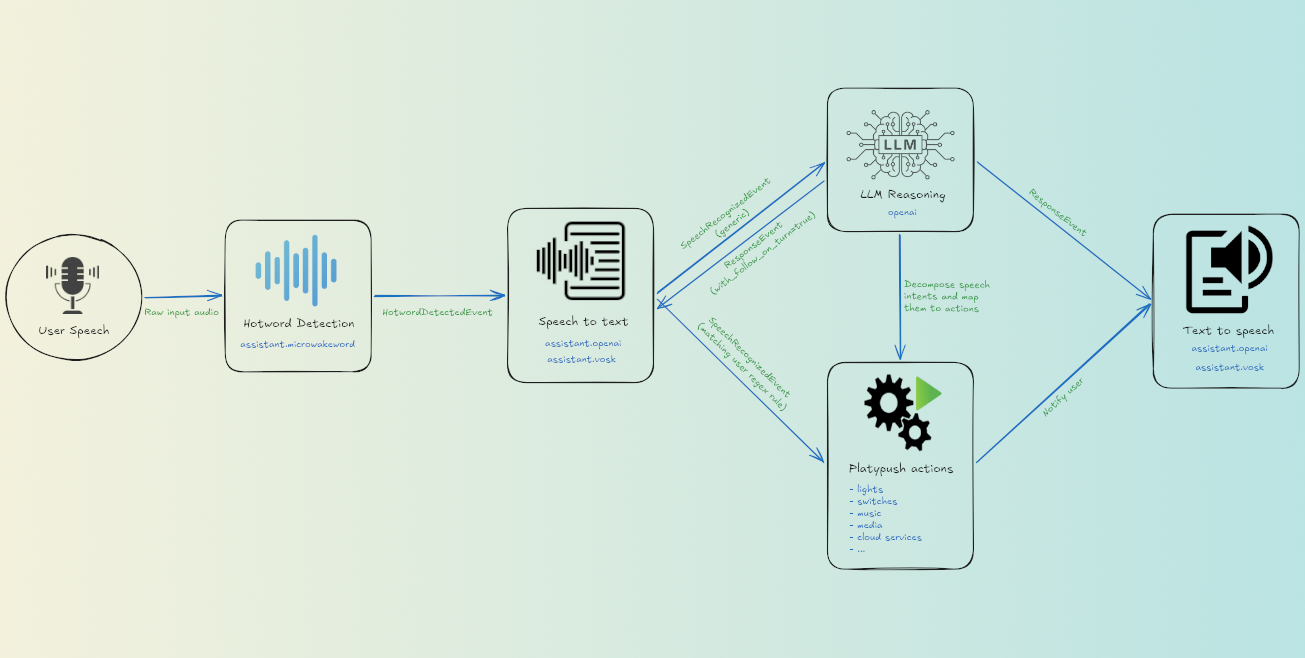
Hacker News'in ana sayfasında da görünen, Platypush blogundaki ayrıntılı yazı, projenin kendi sunucunuzda barındırılan sesli asistan hattının baştan aşağı yeniden inşasını ele alıyor. Yazar, birkaç ay önceki bir makalede anlatılan önceki sürümü günlük olarak kullanıyordu; ancak ticari asistanların gerisinde kaldığını düşünüyordu: uyandırma kelimesi algılayıcısi arka plan gürültüsünde sık sık yanlış pozitif veriyor, konuşmacı mikrofona yakın değilse yanlış negatif üretiyor; gürültülü ortamlarda ve ucuz mikrofonlarla konuşmanın nerede başlayıp bittiğini tespit etmek ise güvenilir değildi.
Yeni bir uyandırma kelimesi motoru
Eski kurulum openWakeWord'ü sarmalayan bir plugin kullanıyordu. Yazıya göre o proje bir süredir sessiz ve önceden eğitilmiş modelleri hâlâ 2023 tarihli, çoğunlukla sentetik konuşmayla eğitilmiş v0.1 dosyaları. Yerine gelen assistant.microwakeword, microWakeWord'ü pymicro-wakeword Python bağlantıları üzerinden sarmalıyor.
Yazar, microWakeWord'ün ESPhome ve Home Assistant Voice'ın arkasındaki motor olduğuna, modellerinin aktif olarak bakım gördüğüne ve paketle birlikte birkaç yerleşik modelin (okay_nabu, hey_jarvis, hey_mycroft ve alexa) geldiğine, dolayısıyla ek indirme gerekmediğine dikkat çekiyor. Özel modeller de destekleniyor: microWakeWord JSON manifestini ve .tflite dosyasını pluginin models dizinine bırakıp adıyla referans vermeniz yeterli.
Yeni plugin bilinçli olarak eskisinin API'sini yansıtıyor; böylece geçiş yalnızca bir yapılandırma değişikliği. Bazı tasarım ayrıntıları öne çıkıyor: açık bir eşik belirtilmezse her model kendi manifestindeki olasılık sınırını kullanıyor (alexa için 0.9); patience_frames varsayılan olarak 0, çünkü modeller çıktıyı zaten kayan bir pencere üzerinde yumuşatıyor; ayrıca ses thread'i TFLite modellerine doğrudan dokunmuyor, kareleri bunun yerine ana thread'e kuyrukluyor, çünkü MicroWakeWord'ün reset metodu yorumlayıcıyı yeniden yüklüyor ve eşzamanlı çağrı için güvenli değil.
Konuşma sonu tespitinin düzeltilmesi
Konuşmadan metne dönüşümü, görüşme sırasında sesi kaydedip Whisper ile yazıya döken assistant.openai üzerinden yürütülüyor. Yazarın belirttiğine göre zor kısım, kullanıcının ne zaman konuşmayı bıraktığını bilmekti. Önceki uygulama WebRTC VAD'den gelen kare başına bir boolean kullanıyordu ve konuşma olarak sınıflandırılan tek bir kare bile sessizlik sayacını sıfırlıyordu — bu yüzden orta düzeyde bile arka plan gürültüsü varken ifadeler yalnızca azami görüşme süresi dolunca sonlanıyordu.
Paylaşılan ses ön işleme katmanı üç yönden yeniden düzenlendi. Birincisi, artık birincil arka uç Silero VAD; onnxruntime üzerinden çalışıyor ve PyTorch gerekmiyor; WebRTC VAD ve RMS tabanlı bir algılayıcı yedek olarak duruyor. İkincisi, histerezis ve kayan pencere sayesinde bir kare eşiğin üzerindeyse konuşma sayılıyor ve puanı belirli bir pay düşene kadar konuşma olarak kalıyor; kare başına kararlar 0.5 saniyelik bir pencere üzerinde çoğunluk oyuyla yumuşatılıyor. Üçüncüsü, zamana göre uyarlanabilir bir gürültü tabanı izleniyor ve yapılandırılabilir bir katmanın (varsayılan 2.0, kabaca 6 dB) altındaki kareler hiçbir zaman konuşma sayılmıyor.
Piper ile üretilmiş ifadeleri mırıltı ve patlama gürültüsüyle karıştıran sentetik bir kıyaslamada eski ayarlar, konuşma bittikten sonra görüşmeleri 6–10 saniye daha açık tutuyordu; yeni hattı ise son kelimeden 1.0–1.6 saniye sonra kapatıyor. Değişiklikler diğer konuşmadan metne entegrasyonlarının paylaştığı AudioPreprocessor'da yapıldığı için assistant.vosk gibi pluginler de bundan yararlanıyor.
Yanıtlar, hook'lar ve konuşma sentezi
Yazıya dönüştürülmüş ifade, API anahtarını ve görüşme bağlamını yöneten openai pluginine gidiyor; bir yanıt soru işaretiyle bitiyorsa görüşme bir takip sorusuyla sürüyor. Özel hook'lar, model çağrılmadan önce ifadeleri yakalayabiliyor — yazıda bir ev otomasyonu komutunun LLM turu olmadan yerel olarak ele alınışı gösteriliyor. Plugin özel bir base URL de kabul ediyor; böylece Ollama örneği gibi OpenAI uyumlu yerel bir sağlayıcı, bulut yerine yanıtları verebiliyor.
Yanıtlar, ses ve ses seviyesi yapılandırılabilir şekilde tts.openai ile seslendiriliyor. Yazar, tts.piper'ın da iyi sonuçlar verdiğini ve tamamen yerel çalıştığını, ancak Raspberry Pi 5'te tts.openai'ya kıyasla yaklaşık 3–4 saniye gecikme eklediğini bildiriyor. Görüşme sürerken uyandırma kelimesi algılaması duraklatılıyor; böylece asistan hoparlörlerden kendi sesini duymuyor.
Neden önemli
Yazı, kendi sunucunuzda barındırılan sesli asistanların çoğunun gerçekte ihtiyaç duyduğu hibrit mimari için pratik bir şablon: uyandırma kelimesi tespiti ve isteğe bağlı olarak STT ve TTS cihaz üzerinde, daha ağır çıkarımlar ise bulutta veya yerel bir model sunucusunda. Ayrıca somut, tekrarlanabilir sonuçları belgeliyor — konuşma sonu gecikmesini 10 saniyeye varan süreden 1.6 saniyenin altına indirmeyi — ve benzer hatlar kuran geliştiricilerin doğrudan ödünç alabileceği thread güvenliği kısıtları, VAD histerezi ve uyarlanabilir gürültü tabanı gibi mühendislik ayrıntılarını da içeriyor. Yazarın kendi geçmişi bu alandaki hızlı değişimi gözler önüne seriyor: önceki sürümlerdeki Snowboy, DeepSpeech ve Alexa entegrasyonunun hepsi artık kullanımdan kalkmış durumda; bu da terk edilmiş motorlar yerine microWakeWord gibi aktif bakım gören motorlar üzerine inşa etmenin güçlü bir gerekçesi.
- #voice-assistants
- #speech-recognition
- #open-source
- #home-automation
- #openai
İlgili yazılar
- OpenAI Agents SDK, yeni issue'ların yüzde 98'ini 30 günde kapattı; Anthropic'un Claude Agent SDK'sı 54'ün 1'ini
- LookAtMyQuant quantization derleyicisi, eşit dosya boyutunda Q4_K_M'ye kıyasla 12 kat daha düşük KL iddia ediyor
- Yıldız satın alan ağlar, kötü amaçlı yazılım barındıran sahte GitHub repolarını trend listelerine taşıyor