· kaynak Hacker News – Front Page (native)
Postgres recovery_prefetch, replica IOPS yükselmesi üzerinden saatler süren yazma kesintileriyle ilişkilendirildi
Bir saha raporu, Postgres'un recovery_prefetch ayarının standby sunucularda okuma IOPS değerini 16 kata kadar yükseltebileceğini yeniden üretiyor; bir ağ aksaklığı ve yazma patlaması bu ayar sayesinde senkron replikasyon altında tüm yazmaları kilitleyebiliyor.
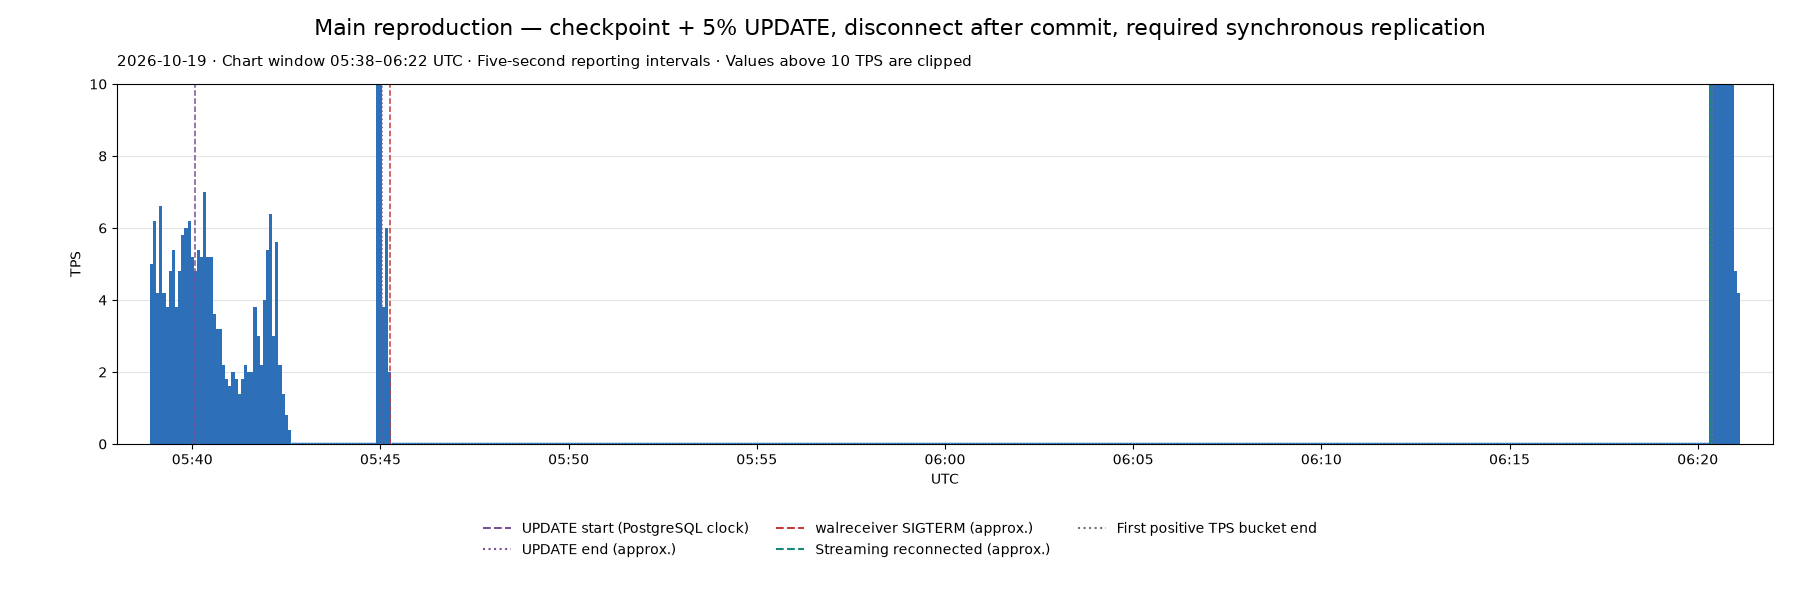
Ardentperf.com'da yayımlanan ve şu anda Hacker News ana sayfasında yer alan "Postgres recovery_prefetch Considered Harmful and Causing Outages" başlıklı bir saha raporu, standby sunucularda WAL yeniden oynatımını hızlandırmak için tasarlanan recovery_prefetch ayarının bunun yerine gerçek üretim kesintilerine yol açabileceğini savunuyor ve senkron replikasyonlu bir kümedeki yazmaları güvenilir biçimde durdurabilen adım adım bir yeniden üretim süreci içeriyor.
İki hata mekanizması
Rapora göre sorunun iki parçası var. İlki, Mart 2025'te Postgres Pro'dan Michael Zhilin tarafından PostgreSQL hackers e-posta listesinde bildirildi: prefetching kodu, WAL'daki full-page image'lardan (FPI) shared buffers'a zaten yüklenmiş olan blokları hesaba katmıyor; bu yüzden startup süreci, diskten okunması hiç gerekmeyen veri için fadvise prefetch çağrıları yapıyor. Zhilin'in müşterisinde, modern ve güçlü bare-metal sunucularda çalışan fiziksel bir standby, yeniden oynatımda saatler geride kalmıştı ve CPU kullanımı kernel alanında yoğunlaşmıştı; olay, recovery_prefetch devre dışı bırakılarak çözüldü.
Rapora göre daha önce teşhis edilmemiş olan ikinci mekanizma ise IOPS yükselmesi (amplification). Birincil sunucu büyük sıralı I/O gerçekleştirdiğinde, recovery_prefetch bu işi replica üzerinde 8 KB'lık rastgele okumalara dönüştürüyor. Okunan bayt sayısı aynı olduğunda, bu durum standby üzerinde okuma IOPS değerini 16 kata kadar yükseltebiliyor — bu da mütevazı bir bulut diskinin IOPS bütçesini tüketmeye ve herhangi bir yazma etkinliği patlamasının ardından replica'ların ciddi biçimde geride kalmasına yetiyor.
Gecikme nasıl kesintiye dönüşür
Yükselme tek başına yalnızca yeniden oynatımı yavaşlatır. Senkron replikasyonla birleştiğinde, yani birincil sunucu en az bir sağlıklı standby'a ulaşamadıkça yazma kabul edemediğinde, bu durum bir kesintiye dönüşür.
Rapor, standby'ın WaitForWALToBecomeAvailable içindeki çekirdek durum makinesini (src/backend/access/transam/xlogrecovery.c) adım adım anlatıyor: WAL'ı arşivden veya pg_wal'dan geri yüklemeye düşen bir standby, geri yakalamadan streaming'e dönemez. Bu yüzden walreceiver bağlantısı, bir yazma patlaması biter biter düşerse, replica, IOPS değeri yükseltilmiş halde yeniden oynatımı öğütürken birincil sunucu, yeniden bağlanmasını bekleyerek her yazmayı bloke eder. Tarif yalnızca "yeterince kötü şans"tır: streaming replikasyonu kesen bir ağ aksaklığı, aynı anda bir yazma patlamasıyla birleşir — yazarın belirttiğine göre bu patlamayı üretmeye VACUUM bile fazlasıyla yeteneklidir.
Yeniden üretim
Yazar, kesintiyi adımlarını öğrendikten sonra yeniden üretmenin çok kolay olduğunu söylüyor ve GitHub'da bir yeniden üretim kurulumu yayımladı. Bir standby'a senkron replikasyonla Postgres çalıştıran küçük sunucularda (2 CPU, 8 GB bellek, 500 IOPS'lik bulut diski):
- pgbench'i scale 640 ile, yaklaşık 10 GB veriyle başlatın
- pgbench_accounts üzerinde autovacuum'u devre dışı bırakın ki müdahale etmesin
- pgbench'i sabit 5 TPS ile çalıştırın
- checkpoint atın ve tablonun %5'ini güncelleyerek bir yazma patlaması oluşturun, sonra bitmesini bekleyin
- Bir ağ veya sistem donmasını taklit etmek için walreceiver sürecini öldürün
Sonuç: TPS sıfıra düşüyor ve tüm yazmalar 30 dakikadan uzun süre asılı kalıyor — daha büyük bir pgbench tablosuyla potansiyel olarak saatlerce. Yaklaşma penceresi sırasında birincil sunucunun diski yaklaşık beş dakika boyunca kabaca 300 IOPS görürken, replica yaklaşık 40 dakika boyunca 500 IOPS sınırına sabitlenmiş durumda bekliyor ve toplamda yaklaşık aynı sayıda bayt okuyor.
recovery_prefetch devre dışı bırakıldığında (full-page writes hâlâ açıkken), UPDATE sırasında hâlâ bir duraklama yaşanıyor ancak ardından bir okuma IOPS patlaması gelmiyor: standby, %5'lik güncellemeyi on dakikanın altında uyguluyor ve güncel kalmayı sürdürüyor.
Kesintilerden önceki uyarılar
Bu endişe yeni değil. Özellik hâlâ geliştirme aşamasındayken — yayımlanmasından yaklaşık bir buçuk yıl önce, Şubat 2021'de — Stephen Frost, PostgreSQL e-posta listesinde, gereksiz yinelenen prefetch'lerin çıkarılmasının FPW'ler kapalıyken bile bir endişe kaynağı sayılabileceği uyarısında bulundu; ancak prefetching'in faydalarının bunun neredeyse kesin olarak ağır basacağı sonucuna vardı ve özelliğin commit edilmesine itiraz etmedi.
Neden önemli
Full-page writes, topluluk Postgres'unun işletim sistemi yeniden başlatmalarında yırtık yazmalara (torn write) karşı korunan tek yolu ve rapora göre üretim kurulumlarının çoğu bunu etkinleştiriyor. Bu arada senkron replikasyon, Kubernetes ve standart donanımda giderek standart dayanıklılık seçeneği haline geliyor. Rapor, bu yaygın yapılandırmada recovery_prefetch'in faydalarının şüpheli, buna karşılık hata modunun — sıradan bir ağ aksaklığından kaynaklanan tam bir yazma kesintisinin — ağır olduğunu savunuyor. Yazar, topluluk tartışması yapılana kadar bu ayarı her yerde devre dışı bırakmaya meyilli olduğunu belirtiyor ve ayrıca, tek bir walreceiver bağlantısının tüm kümenin yazma kullanılabilirliği için kırılgan bir bağımlılık olduğu gerekçesiyle quorum commit (ANY 1) ile iki standby çalıştırılmasını öneriyor.
- #postgres
- #replication
- #databases
- #reliability
- #performance