· kaynak Hacker News – Front Page (native)
Spekülatif decoding, bellek sınırlı işi hesaplama sınırlı işle takas ederek LLM çıkarımını hızlandırıyor
jbarrow.ai'de yayımlanan teknik bir yazı, spekülatif decoding'in toplam FLOP sayısını artırdığını, hızlanmanın ise boşta geçen bellek sınırlı GPU zamanını küçük batch boyutlarında faydalı hesaplama sınırlı işe dönüştürmesinden kaynaklandığını savunuyor.
Yanlış anlaşılma, düzeltildi
Hacker News ana sayfasına ulaşan jbarrow.ai'deki teknik bir yazı, spekülatif decoding'in hızlanmasına dair yaygın bir açıklamayı hedef alıyor. Popüler anlatı, bir taslağı doğrulamanın o token'ları üretmekten daha az FLOP'a mal olmasıdır. Yazara göre bu yanlış: aynı çıktı dizisi için spekülatif decoding toplamda daha az değil, daha fazla kayan nokta işlemi gerçekleştirir. Doğru bir taslak modelin aslında size sağladığı şey hesaplamadan tasarruf değil, farklı bir GPU işi karışımıdır.
Teknik nasıl çalışır
Spekülatif decoding küçük bir taslak modeli büyük bir hedef modelle eşleştirir. Taslak model olası token'lardan oluşan kısa bir dizi önerir ve büyük model hepsini tek bir paralel forward pass içinde kontrol ederek kendisinin üreteceği token'ları tutar. Geleneksel otoregresif decoding ise forward pass başına tek bir token üretir.
İki tür GPU darboğazı
Açıklama, GPU'yu herhangi bir anda neyin sınırladığına dayanıyor. Matris çarpımları ve nokta çarpımları gibi tensör işlemlerinin yanı sıra GPU, ağırlıkları global ve yerel bellek arasında taşımakla da zaman harcar. Bu aktarımları beklerken bir adım bellek sınırlıdır (memory bound); veri hazır olduğunda ve kısıtlayıcı faktör aritmetik olduğunda ise hesaplama sınırlıdır (compute bound).
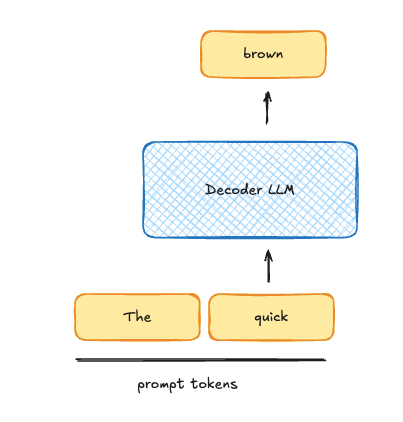
Tek token'lı decoding güçlü biçimde bellek sınırlıdır: üretilen her token, GPU'nun modelin tüm aktif parametrelerini akıtmasını zorunlu kılar; yazı bunu 27 milyar parametreli Qwen3.5-27B örneğiyle gösteriyor. Adım başına binlerce token işleyen batch'li decoding ise bunun tersi olan hesaplama sınırlı uçta yer alır.
Bu bellek sınırlı rejim aritmetik birimleri boşta bırakır. Yazar, iki dizinin decoding'inin token başına tek dizininkinden daha uzun sürmediğine dikkat çekiyor; çünkü ek hesaplama kapasitesi zaten kullanılmıyordu. Spekülatif decoding, düşük batch boyutlarında, bu fazlalığı harcamanın bir yoludur.
Dizileri batch'lemek ile derine spekülasyon yapmak
Yılgı, örnekle somutlaştırıyor: belirli bir kurulumda forward pass başına beş token optimum olsun; daha azı GPU'yu bellek sınırlı bıraksın, daha fazlası hesaplama sınırlı yapsın. Bu optimuma iki yoldan ulaşabilirsiniz. Beş diziyi batch'leyip her biri için bir token decode edin ya da tek dizi tutup onun için beş spekülatif token doğrulayın. GPU her iki durumda kabaca aynı işi yapar; fark, beş dizinin biraz ilerlemesi mi yoksa tek dizinin çok ilerlemesi midir.
Aynı mantık tekniğin sınırlarını da ortaya koyar. Büyük bir batch'i sabit bir spekülasyon derinliğiyle birleştirdiğinizde hesaplama sınırlı eşiği aşarsınız ve her isteği yavaşlatırsınız. Reddedilen token'lar durumu daha da kötüleştirir; çünkü reddedilen her token, kabul edilmiş bir çıktı üretmeyen saf yük demektir.
Sunum ve araştırma üzerindeki sonuçları
Bu yüzden teknik evrensel bir kazanç değil, düşük batch'li bir optimizasyondur. Yazı, vLLM'nin --speculative-disable-by-batch-size bayrağını sunduğunu, böylece operatörlerin batch'ler yeterince büyüdüğünde spekülasyonu tamamen kapatabildiğini belirtiyor.
Analiz ayrıca bir araştırma yönüne de motivedir: doğru derinlik ne kadar hesaplamanın boşta olduğuna bağlıysa, neden her zaman adımında aynı derinliğe kadar spekülasyon yapılsın? Yazar, dSpark gibi çalışmaların tam da bu sezgi üzerine kurulduğuna işaret ediyor: batch'ler küçükken ve hesaplama boşken derine, değilken sığ olarak ya da dizi başına uyarlanabilir biçimde spekülasyon yapmak.
Neden önemli
Çıkarım mühendisleri için bu yazı, belirsiz bir "daha az iş" zihinsel modelini harekete geçirebileceğiniz bir modelle değiştiriyor. Spekülasyonun faydalı olup olmadığı, bir iş yükünün bellek sınırlı ile hesaplama sınırlı çalışma arasında nerede durduğuna ve taslak modelin kabul oranına bağlıdır. Dağıtımların ölçeği büyüdükçe sabit spekülasyon derinliği sessizce hızlandırıcıdan yüke dönüşür; dinamik, yükü algılayan derinliğin hem üretim sunum yığınlarında hem de araştırma literatüründe ilgi çekici yeni sınır haline gelmesinin nedeni de budur.
- #speculative-decoding
- #llm-inference
- #gpu
- #vllm
- #machine-learning