· kaynak Hacker News – Front Page (native)
TypeSafe'ın Jev sınıflandırıcısı fizik kalibrasyon testinde düz tahmini ancak geçebildi
Bağımsız bir analiz, TypeSafe'ın System One sınıflandırıcısı Jev'i cevabı bilinen on fizik dağılımına karşı test etti ve olasılıklarının eşit dağıtılmış bir tahminden ancak biraz iyi, kimi zaman ise daha kötü olduğunu buldu.
Jev nedir
TypeSafe, büyük dil modellerinin rakibi değil yanı olarak konumlanan bir "System One" sınıflandırıcı olan Jev'i yayınladı. Hacker News'in ana sayfasına çıkan Maximum Effort Substack'te yayımlanan bağımsız bir analize göre isim, Daniel Kahneman'ın Hızlı ve Yavaş Düşünme kitabına gönderme yapıyor: Claude veya GPT gibi LLM'ler yavaş, deliberatif System Two akıl yürütmesini üstlenirken, Jev ve öncülü Laya gibi "Karar Modelleri" hızlı, içgüdüsel System One yargıları için tasarlanmış.
Analiz mimariyi şöyle tasvir ediyor: önceden eğitilmiş bir transformer genel yeteneğini koruyor ve çıktısına bir sınıflandırıcı ekleniyor. Çağırıcı, serbest biçimli metin yerine bir bağlam ve çoktan seçmeli bir soru veriyor; karşılığında seçenekler üzerinde olasılık dağılımıyla birlikte tipli bir yanıt alıyor. Yazar bunu tipik bir LLM çağrısıyla karşılaştırıyor: bir sohbet modeline 2 + 2'nin kaç ettiğini sorduğunuzda hâlâ ayrıştırmanız gereken bir dize dönüyor, oysa Jev doğrudan 4 tam sayısını döndürüyor. Tüm değerlendirmenin maliyeti bildirildiğine göre 4 doların altında.
dev.to'daki ayrı bir öğretici, hedeflenen üretim desenini gösteriyor. TypeSafe'ın TypeScript SDK'sı tek bir paylaşılan durum nesnesi ile bir dizi bağımsız soru alıyor; noul, choice ve score adlı primitifleri kullanıyor ve tümü bu duruma karşı paralel olarak değerlendiriliyor. Sorular ticket.messages[0].text gibi nokta-ve-indeks yollarıyla verilere işaret ediyor; öğretici dar şemaları, ucuz diff için değişmez (immutable) güncellemeleri ve prompt injection'ı etkisizleştirmek için güvenilmeyen metni şema düzeyinde izole etmeyi tavsiye ediyor. Yazı yazarının ücretli e-kitabını tanıttığı için performans iddiaları buna uygun bir şüpheyle karşılanmalı.
Fizikle kalibrasyonun test edilmesi
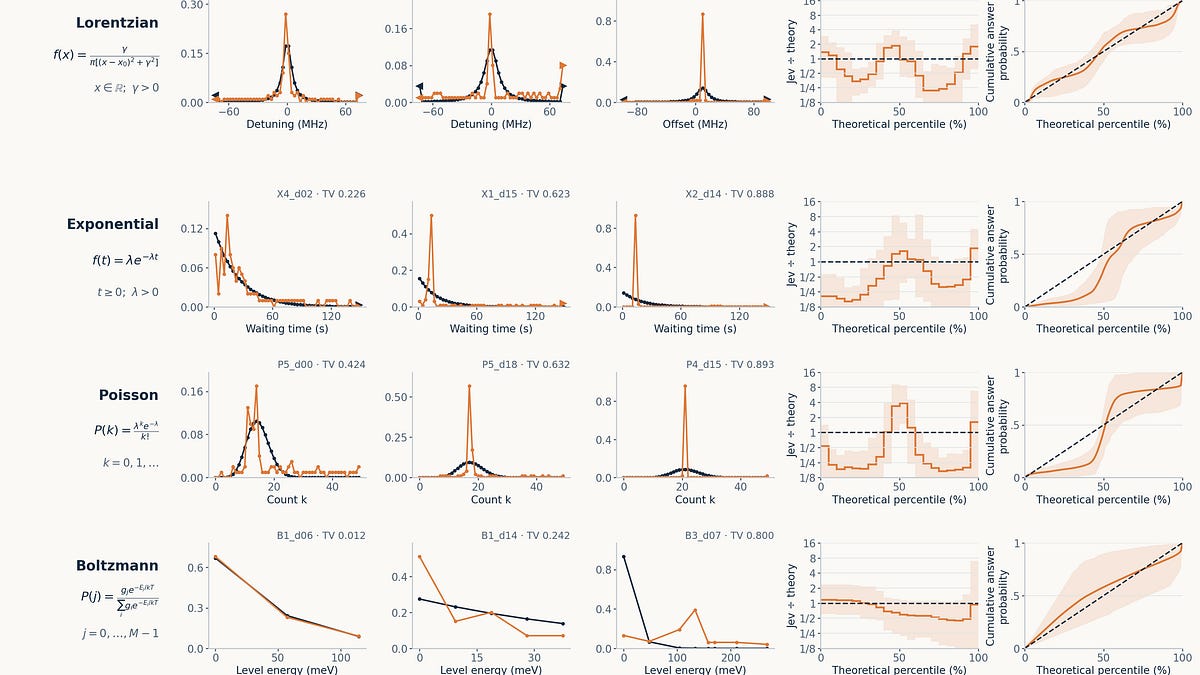
Substack yazarının sorusu basitti: Jev bir olasılık bildirdiğinde bunun bir anlamı var mı? Test alanı, cevabı tam olarak bilinen sorulardı; yani fizik olasılık dağılımları. On aile kullanıldı (Gaussian, Lorentzian, Maxwell, Gamma, Exponential, Rayleigh, Uniform, Poisson, Binomial ve Boltzmann); her biri beş prompt şablonu ve şablon başına 20 varyasyonla, toplam 1.000 ayar. Jev'den sürekli bir parametrenin sabit aralıkları (bin) arasından seçim yapması istendi; iyi kalibre edilmiş bir model her aralığa gerçek dağılımın ima ettiği olasılık kütlesini atamalıydı. Şablonları, API çağrılarını ve grafikleri GPT-6 Astra ve Claude Opus 5.5 hazırladı.
Sonuçlar
nPuanlama toplam varyasyon mesafesiyle yapıldı: 0, Jev'in dağılımının teoriyle örtüştüğü; 1, tamamen ayrıştığı anlamına geliyor. Jev ortalama 0.518 aldı. Bilgi iddiasından tamamen vazgeçip olasılığını tüm seçeneklere eşit dağıtsaydı ortalama 0.546 alacaktı; yani çok az daha kötü. Uniform sorularında Jev 0.77 skor aldı, bilgisiz taban çizgisi ise 0.39; dolayısıyla eşit dağılım modelden çarpıcı biçimde daha iyi kalibre edilmişti. Poisson'da ikisi 0.65'e karşı 0.64 ile fiilen eşitti.
Analizde iki başarısızlık deseni öne çıkıyor. Birincisi, Jev'in çıktı dağılımları aşırı yoğun ve model, gerçek olasılığın neredeyse sıfır olduğu aralıklara sıfır olmayan ağırlık vererek düzgünce yok olan kuyrukları yanlış ele alıyor. Lorentzian görece iyi skor aldı; yazar bunun, o ailenin doğası gereği sivri tepeli ve ağır kuyruklu olmasından şüpheleniyor. İkincisi, bir dağılımın tepesini bulma konusundaki görünen yetenek kısmen kopyalama olabilir: Gaussian tarzı promptlarda merkez prompt'ın kendisinde yazılı. Tepeyi okumak yerine türetmenin gerektiği Maxwell, Rayleigh ve Gamma'da Jev tepenizi ayarların yalnızca yaklaşık %20'sinde bulabildi ve çok düz dağılımlar döndürdü; Rayleigh ve Gamma için makul görünen uniform yanıtlar üretti ki yazar bunu modelin belirsizlik sinyali vermesi olarak yorumluyor.
Sonuçları neler
Yazar acil bir çıkarıma dikkat çekiyor: bu modelleri LLM yanıtlarının otomatik yargıcı olarak kullanan JevEval gibi değerlendirme çerçeveleri, yargıcın kendi olasılıkları ders kitabı problemlerinde ciddi biçimde ışa yapıyorsa sarsıntılı görünüyor. Bu endişe, dev.to öğreticisinin gösterdiği kullanım desenine doğrudan çarpıyor; orada iş mantığı yalnızca birkaç Jev olasılığının hepsi 0.8'i aştığında tetikleniyor. Bir skor üzerine eşik koymak ancak skor kalibre edilmişse işe yarar.
Neden önemli
Jev, metin üretimi yerine hızlı yanıt döngülerinde ucuz, tipli, olasılıksal sınıflandırma vaat eden, LLM'e komşu yeni bir karar modeli sınıfını temsil ediyor. Bu vaat tamamen olasılıkların güvenilir olmasına dayanıyor ve 4 dolarlık bir deney şu anda öyle olmadıklarını gösteriyor; bazı ailelerde model hiçbir şey bilmeyip düz tahmin etmekten daha kötü yaptı. Böyle skorları otomatik kararlara bağlayan ekipler, kalibrasyon iyileşene kadar bunlara ancak zayıf sıralama sinyali olarak davranmalı; deneyin kendisi de kalibre olasılık çıktısı iddiasındaki herhangi bir modeli denetlemek için yeniden kullanılabilir, düşük maliyetli bir şablon.
- #machine-learning
- #calibration
- #classification
- #llm
- #evaluation
İlgili yazılar
- ElderAI, 100 dolarlık coding model fine-tuning'undan dersler paylaştı; hiçbir çalışma kendi kalite eşiğini geçemedi
- Ataraxos AI, tarihin en iyi Stratego oyuncusunu yalnızca 16 GPU ile yendi
- Redis'in yaratıcısı antirez, DeepSeek ve Qwen modellerini yerel olarak çalıştıran ds4 adlı hafif bir C motorunu yayınladı