· kaynak Hacker News – Front Page (hnrss.org)
Uber, çapraz servis retry fırtınalarını durdurmak için hata sahipliğini çağrı zincirleri boyunca atıyor
Uber Engineering, hataları sahiplik etiketiyle işaretlemenin çağıran tarafların yalnızca hatayı üstlenen servis durumunda yeniden denemesine izin verdiğini ve yerel bir kesintiyi platform geneli bir olaya dönüştüren çarpımsal yükü sınırladığını anlatıyor.
Uber'in çözdüğü sorun
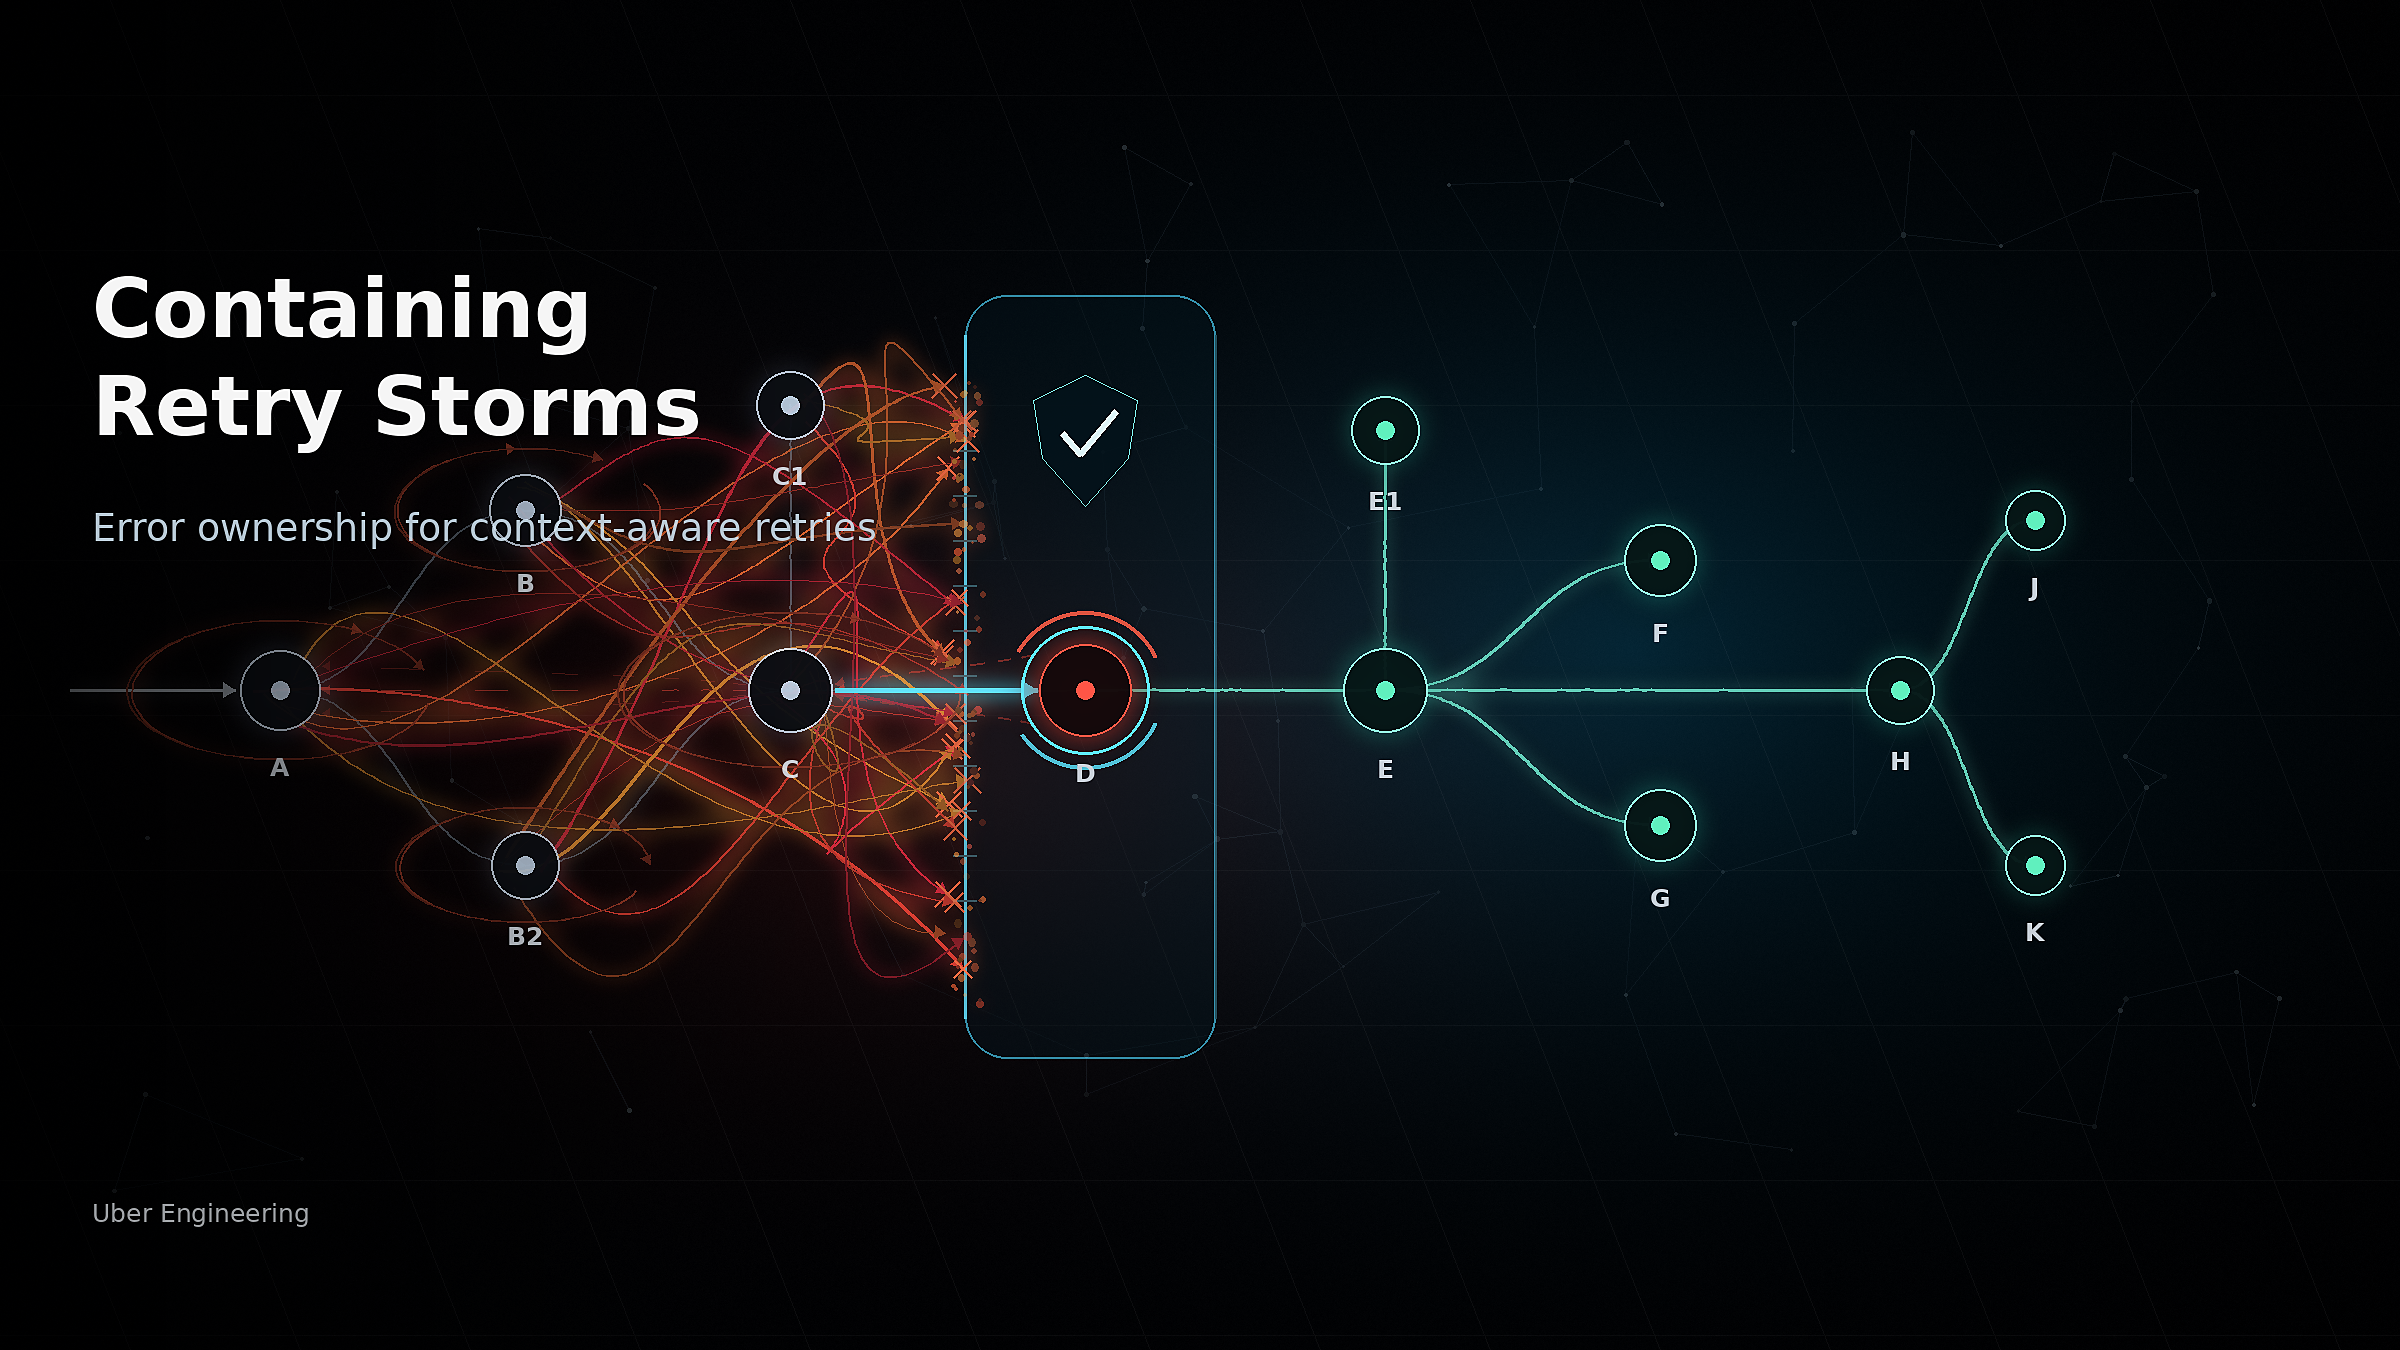
Uber, üretim sistemlerini retry fırtınalarına karşı nasıl koruduğunu anlatan bir mühendislik yazısı yayımladı; yazı Hacker News ana sayfasında da öne çıktı. Retry fırtınaları, otomatik yeniden denemelerin zaten zorlanan bir servisin üzerine yığıldığı ve yerel bir kesintiyi tüm yığını kapsayan bir olaya dönüştürdüğü zincirlemelerdir. Yazıya göre bu tür fırtınalar geçmişte hem operasyonları hem de marka güvenini zedelemişti ve Uber'in mevcut savunmaları — servis bazında retry ayarı ve retry bütçeleri — ortak bir zayıflığa sahip: elle yapılandırılıyorlar ve yeniden denemelerin derin bağımlılık zincirleri ile dağıtık (fan-out) yapılar boyunca nasıl katlandığına dair hiçbir görünürlük sunmuyorlar.
Uber'e göre daha derin boşluk, retry davranışının bağlama duyarlı olmaması. Bir sistem kaç yeniden deneme gerçekleşeceğini sınırlayabilir ama belirli bir yeniden denemenin değer olup olmadığını判断 edemez; çünkü çağıran taraflar, bir bağımlılığın ürettiği hatayı yalnızca ilettiği bir hatadan güvenilir biçimde ayırt edemiyor. Şirket, downstream hata kodlarını upstream'e çevirmeyi düşündü ama bu fikri reddetti: Uber'in fan-in, fan-out ve sürekli evrilen çağrı grafikleri ölçeğinde bu yaklaşım ayak uyduramazdı. Bunun yerine seçilen çözüm, paylaşımlı altyapıda yaşıyor.
Yeniden denemeler nasıl katlanır
Yazı aritmetiği açıkça ortaya koyuyor. Yedi servislik bir zincir alın; kararlı durumda her biri aynı sayıda istek alsın. Üçüncü derinlikteki servis başarısız olmaya başlarsa ve her atlama bir kez yeniden deneme yaparsa, yük her seviyede iki katına çıkar: o düğüm ve altındaki her şey taban trafiğin sekiz katını sunmak zorunda kalır. Genelleştirirsek, d derinliğindeki bir düğüm tabanın R üzeri d katını görür; burada R atlama başına retry çarpanıdır. Tek bir hasta düğüm artık altı düğümü sele boğuyor.
Yüzde 10'luk bir retry bütçesi formülü (1+B) üzeri d olarak dönüştürür ve aynı örnekteki en derin servisleri tabanın yaklaşık 1,33 katına yakın sınırlar — önemli bir iyileşme. Ancak bütçeler hataların bağımsız ve yeniden denemelerin büyük olasılıkla başarılı olacağı varsayımına dayanır. Uber'in kendi sayıları, çağıran tarafın aslında yüzde 90 çalışmakta olan bir çağrılan servisten kabaca yüzde 99 kullanılabilirlik algıladığını gösteriyor; ama yazı, aşırı yük durumunda — kötü veritabanı host'ları, veritabanı doygunluğu veya sharding sorunlarıyla — hataların bağıntılı olduğunu vurguluyor; dolayısıyla yeniden denemeler nadiren bir şey kurtarırken yük ekliyor. Bozulan bir servise daha sert retry yapmak başarısızlığı hızlandırıyor.
Hata sahipliği
Uber'in cevabı, belirti ve neden karşıtlığı çerçevesinde hata sahipliği. Bir servis bir isteği yerine getirmek için giden çağrılar yapıyorsa ve bunlardan biri başarısız olup servisin hata döndürmesine neden oluyorsa, o hata yalnızca bir belirtidir; neden downstream'dedir. Hiçbir giden çağrı başarısız olmadıysa ve servis yine de hata veriyorsa, hatanın sahibi servisin kendisidir. Uber'in Service Dependency Analysis Solution'ı, istek başına gelen hataları giden hatalarla bağıntılandırır ve sahipliği üstlenen ya da reddeden bir karar mantığı uygular; sonuç, hata sahiplik (error-claim) başlıklarında ifade edilir.
Çağıran taraflar bundan sonra retry davranışını buna göre uyarlar. Çağrılan servisin hatayı kendisinin olarak kabul ettiği, sahiplenilmiş bir hata yeniden denenebilir; çünkü ikinci deneme için doğru hedef o servistir. Çağıran tarafın yalnızca ilettiği, sahiplenilmemiş olarak işaretlenmiş bir hata ise yeniden denememelidir; bir aracıyı yeniden denemek aynı downstream hatasını yeniden oynatmaktan ibarettir. Sahiplik başlıklarının bulunmadığı durumlarda — downstream servisin bağımlılık analizine veya yeterli bağlam yayılımına sahip olmadığı durumlarda — bunu ilk fark eden düğüm hatayı sahipsizleştirir; yeniden denemeler yine de hataya en yakın kenarda gerçekleşir ama bozulma yığın yukarı tırmanmayı durur.
Yazı ayrıca bir karar matrisinde karışık senaryoları ele alıyor ve tesadüfi hatalara dikkat çekiyor: bir düğüm, bağımlılık analizinin izlemediği örneğin aşırı yüklenmiş bir cache nedeniyle dahili olarak başarısız olabilir, tam da fail-open bağımlılıklarının da zorlandığı anda — bu yüzden yalnızca statik topoloji yerine istek başına bağıntı gerekiyor.
Neden önemli
Retry fırtınaları Uber'e özgü bir merak değildir; otomatik yeniden deneme yapan her mikro servis mimarisinin varsayılan başarısızlık kipidir. Aktarılabilir ders mimariseldir: ne zaman yeniden deneneceği kararını paylaşımlı platform altyapısına itin, bu kararı hatanın gerçekte nerede doğduğuna koşullandırın ve şiddetli bir bozulma altında doğru retry politikasının çoğu zaman durmak olduğunu kabul edin. Servis bazında bütçeleri zaten ayarlamış ama yine de zincirlemelerin oluştuğunu izlemiş ekipler için sahiplik modeli somut bir sonraki adım sunuyor.
- #microservices
- #distributed-systems
- #reliability
- #resilience
- #uber