· kaynak Hacker News – Front Page (hnrss.org)
UTF-8000, UTF-8'in sınırsız bir uzantısını pip ile kurulabilir bir referans uygulamayla öneriyor
Hacker News'te ortaya çıkan bir proje, UTF-8'in değişken uzunluklu şemasını rastgele uzunluktaki kod birimlerine genişletirken özelliklerini koruyan ve bir Python referans uygulamasıyla gelen UTF-8000 adlı bir kodlama öneriyor.
UTF-8'in uzunluk sınırlarını kaldırırken tüm özelliklerini koruyan bir kodlama önerisi olan UTF-8000, Hacker News'in ana sayfasına yerleşti. Projenin sitesine göre şema, ASCII ve geleneksel UTF-8'i iç içe alt kümeler olarak tamamen dokunulmaz bırakıyor ve formatı, tek bir kod biriminin rastgele sayıda byte'a uzanabileceği şekilde genişletiyor. Sitede bunun eğlenceli bir bağımsız proje ve öneri olduğu, Unicode Consortium tarafından hiçbir şekilde onaylanmadığı ya da onları temsil etmediği açıkça belirtiliyor.
Baştaki bit deseninin genişletilmesi
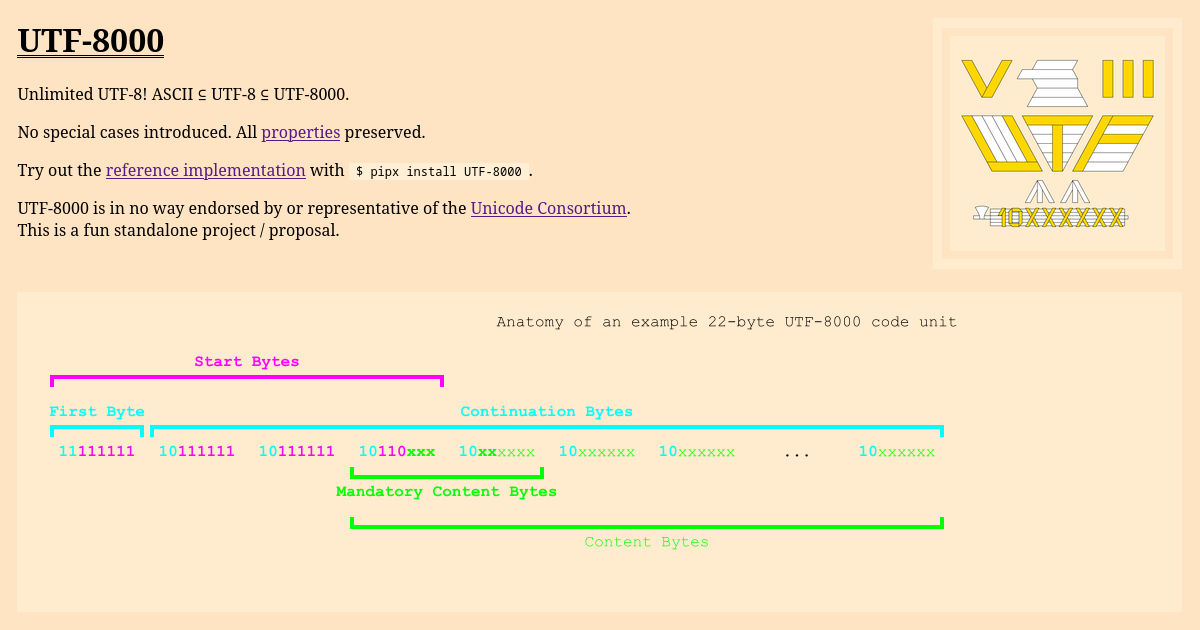
UTF-8, bir kod biriminin uzunluğunu ilk byte'ının yüksek bitleriyle duyurur: 110xxxxx iki byte, 1110xxxx üç, 11110xxx dört anlamına gelir ve sonraki her byte 10xxxxxx devam byte'ıdır. Proje sayfasında belgelendiği gibi UTF-8000 bu ilerlemeyi basitçe sürdürür: beş byte için 111110xx, altı için 1111110x ve yedi için 11111110. Sekiz byte'da baştaki byte tükenir, çünkü tamamen birlerden oluşur; bu yüzden şema, projenin çoklu başlangıç byte'ları (multiple start bytes) dediği şeyi ortaya koyar. Sekiz byte'lık bir birim 11111111 100xxxxx ile, dokuz byte'lık bir birim 11111111 1010xxxx ile, on byte'lık bir birim 11111111 10110xxx ile başlar ve uzunluklar oradan yükselmeye devam eder. Sitedeki 22 byte'lık bir örnek, 11111111 10111111 10111111 10110xxx ile açılır ve ardından devam byte'larıyla sürer.
22 byte'lık bir birimin anatomisi
Tasarımın ilginçleştiği yer uzun birimlerdir. 22 byte'lık örnekte proje, dördüncü numaralı byte'ı öne çıkarır; bu byte aynı anda bir devam byte'ı (üst bitleri 10'dur), bir başlangıç byte'ı, son başlangıç byte'ı ve içerik bitlerinin taşıyıcısıdır; zorunlu içerik bitlerinin yalnızca bir kısmını tutar ve bu bitler o byte ile ondan sonraki ilk başlangıç-olmayan byte'ın arasına yayılır. Proje ana katkısını bir netlik meselesi olarak tanımlar: UTF-8'in ilk byte'ındaki en yüksek bitleri öz-eşzamanlama bitleri ve başlangıç bitleri olarak ayırmak, sonra bir birimin tek bir başlangıç byte'ının ifade edebileceğinin ötesine büyümesi gerektiğinde başlangıç bitlerinin devam byte'larına nasıl serileceğini göstermek. Site, 22 byte'lık örnekte özel olarak ele alınan bir şey olmadığını vurgular; bu, çoklu başlangıç byte'larının olanaklı kıldıklarının tipik bir gösterimidir.
Aynı kalan nedir
Tüm tasarımında yalnızca iki özel durum vardır ve projeye göre ikisi de UTF-8'den mirastır: ASCII olduğu gibi kodlanır ve iki byte'lık birimler, daha uzun tüm kod birimlerinin gerektirdiği beş bit yerine, aşırı uzun kodlamalara karşı denetimde kullanılan dört zorunlu içerik biti taşır. Yeni özel durumlar eklenmez ve bilinen özellikler — ASCII alt kümesinden öz-eşzamanlamaya ve önek yapısına kadar — değişmeden aktarılır.
Kurulum yapabileceğiniz bir referans uygulama
Fikirle doğrudan oynamak isteyenler için proje, pipx install UTF-8000 ile kurulabilen bir referans uygulama sunuyor; böylece kodlama, yalnızca okunacak değil, deneyimlenebilecek bir şey oluyor.
Neden önemli
Modern Unicode U+10FFFF'te durur ve bugün kullanımda olan UTF-8 bu tavana dört byte'la ulaşır; yani kimsenin kod birimi alanı sıkıntısı yoktur ve proje bunun aksini iddia etmiyor. Değeri başka yerde. UTF-8000, UTF-8'in arkasındaki baştaki bit şemasının sabit bir dört basamaklı merdiven değil, genişletilebilir bir sistem olduğunun temiz bir gösterimidir ve parçaları — öz-eşzamanlama bitleri ile başlangıç bitleri — üzerine akıl yürütülebilecek kadar kesin biçimde adlandırır. Metin boru hatları, parser uç durumları ya da genel olarak öz-eşzamanlayan kodlarla uğraşan mühendisler için bu ayrıştırma gerçekten öğreticidir ve kurulabilir uygulama, fikri salt kuramsal rather than test edilebilir kılar. Sınırlar da aynı derecede açık: daha geniş ekosistemdeki hiçbir şey bu uzun birimlerin kodunu çözemez, dolayısıyla referans araçlarla kodlanan her şey yalnızca o araçlarla gidiş-dönüş yapabilir ve Unicode Consortium'un hiçbir ilgisi yoktur. En iyi, tesadüfen kod da sunan iyi belgelenmiş bir düşünce deneyi ve çoğu insanın ikinci kez bakmadan kullandığı bir kodlamanın içinde ne kadar zarif bir mekanizma yattığının bir hatırlatıcısı olarak okunmalı.
- #unicode
- #utf-8
- #character-encoding
- #python
- #open-source
İlgili yazılar
- Planvio, Yapay Zekanın Gerçek Proje İşlerini Yönetilen Araçlar Üzerinden Değiştirmesine İzin Veriyor
- Browser-use iç yapısı: DOM damıtma, Set-of-Mark grounding ve kendini onaran web agent'ları
- KDE 30 yaşında: Akademy konuşması Plasma'yı kullanıcıya göre kendini derleyen AI-native bir masaüstü olarak konumlandırıyor