· kaynak Hacker News – Front Page (native)
Yeni algoritma, ARM ve x86 üzerinde sabitlerle 64-bit işaretli floor bölmesini hızlandırıyor
benjoffe.com'da yayımlanan bir yazı, bölen derleme zamanında bilindiğinde 64-bit işaretli floor bölmesi için daha hızlı bir algoritma tanıtıyor; kıyaslamalarda ARM'da mevcut yöntemlerden %10-20, x86'da ise çoğu bölende %5-10 daha hızlı.
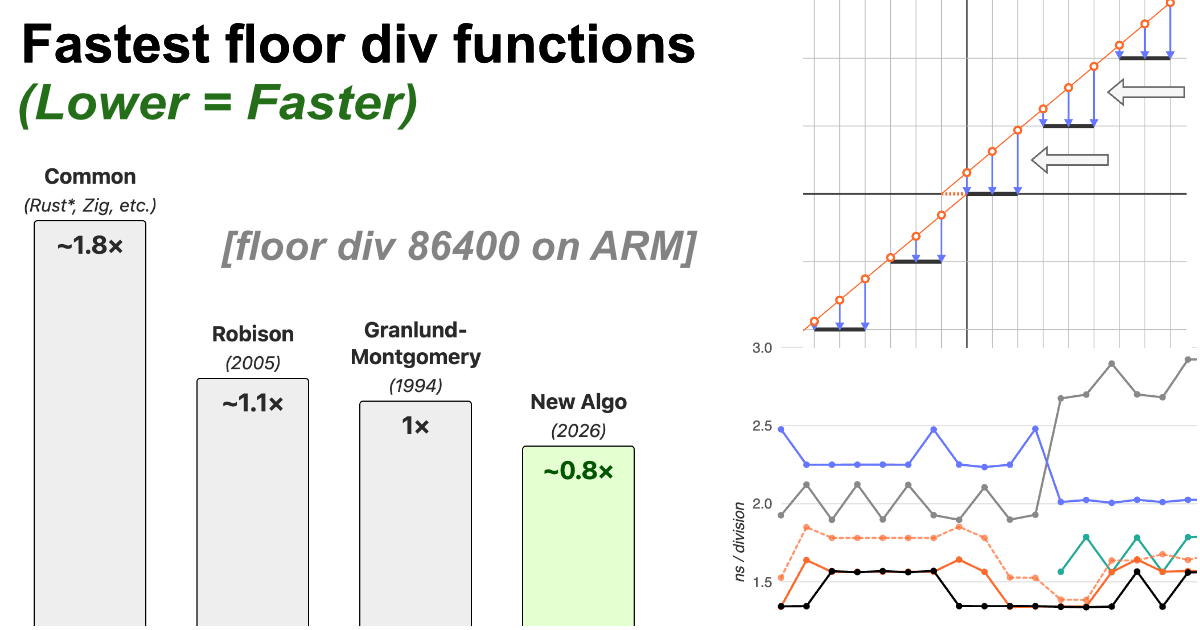
27 Ekim 2026'da benjoffe.com'da yayımlanan ve iki gün sonra Hacker News'te öne çıkan bir yazı, bölen derleme zamanında bilindiğinde işaretli 64-bit floor bölmesi için yeni bir algoritma tanıtıyor. Yazarın kıyaslamalarına göre algoritma, ARM çiplerindeki en iyi mevcut algoritmalardan %10-20, x86'da ise çoğu bölende yaklaşık %5-10 daha yüksek iş hacmi sağlıyor; bu, 1990'ların ortasından beri pek ilerleme kaydedilmemiş bir tamsayı aritmetiği köşesinde somut bir kazanç.
Floor bölmesinin çözdüğü sorun
Floor bölmesi negatif sonsuza doğru yuvarlarken, C, C++ ve diğer birçok dilde yerleşik olan kesik (truncated) bölme sıfıra doğru yuvarlar. Fark, bölünenler negatif olabildiği andan itibaren önem kazanıyor: Saniye cinsinden bir Unix zaman damgasını 86400'e bölerek gün sayısını elde etmek, biri 1970 öncesi bir tarih girene kadar kesik bölmeyle sorunsuz çalışıyor. Takvim aritmetiği, tile koordinatları ve açı takibi için genellikle gereken semantik floor olanıdır.
Ancak yazarın ifadesiyle bu alandaki ekosistem kötü durumda. Ana akım derleyiciler ile C, C++, Go ve Swift gibi diller floor bölmeyi yerleşik olarak sunmuyor. Var olan uygulamalar neredeyse hiçbir zaman en hızlı bilinen algoritmaları kullanmıyor ve öne çıkan en az bir yazılım kütüphanesi taşan, hatalı bir sürümü dört yıldan uzun süre yayımladı. Tipik web aramaları ve LLM promptları yalnızca yavaş yaklaşımları ortaya çıkarıyor ve düşük seviye aritmetiğin standart başvuru kaynağı olan Hacker's Delight konuya neredeyse hiç yer ayırmıyor.
Derleyiciler bugün sabitlerle nasıl bölüyor
Bölenden biri derleme zamanında sabitlendiğinde derleyiciler, CPU'nun bölme talimatını atlar ve bunun yerine bir çarpma-kaydırma dizisi üretir: bölünen, önceden hesaplanmış bir magic sabitiyle daha geniş bir register'da çarpılır, kaydırılır ve işaretli bölme için negatif sonuçların sıfıra doğru yuvarlanmasını sağlayan, işaret bitine dayalı son bir düzeltme uygulanır. 100 dahil bazı bölenler, yazının tabiriyle uyumsuz: magic sabitleri tüm 64 biti gerektiriyor, bu da ek bir düzeltme adımını zorunlu kılıyor. Genel olarak yazar, sıradan sabit bölmenin maliyetini yaklaşık bir çarpma artı 2-3 çevrim olarak değerlendiriyor.
Yeni hile
Yenilik, floor düzeltmesini çarpanın kendisine katmak. Sonucu sabit bir sabitle çarpıp sonra yamalamak yerine algoritma, değerin 63 sağa kaydırılmasıyla ucuz şekilde elde edilen bölünenin işaret bitini, tek bir 128-bit çarpmadan önce magic sabitine ekliyor. Çarpımın yüksek kısmı uygun şekilde kaydırıldığında floor bölümlenmiş bölüm tek geçişte elde ediliyor. 86400 için verilen örnekte sabit, 2^79'un bölene bölünmesinden türetiliyor ve çarpım 79 sağa kaydırılıyor. Yazar, fikrin önceden yapılmış bir çalışma bulunabilecek kadar basit olduğunu kabul ediyor, ancak hiçbir yerde belgelenmiş bir örnek bulamadığını belirtiyor ve sayfayı kısmen tekniğin keşfedilebilir olması için sunduğunu söylüyor.
Kıyaslamalar ne gösteriyor
Yazıya göre ideal derleme koşullarında sonuçlar şöyle:
ARM'da, bir Apple M4 Pro ve bir Snapdragon X1-26-100 üzerinde test edildiğinde, çoğu 64-bit bölende iş hacmi mevcut algoritmalardan %10-10-20 daha hızlı; ara sıra eşit, gecikme eşit ya da daha iyi.
x86'da, bir AMD Ryzen 9 9950X3D ve bir Intel Core i7 üzerinde test edildiğinde, pozitif bölenlerin yaklaşık %80'inde ve negatif bölenlerin %60'ında iş hacmi yaklaşık %5-10 artıyor; kalan durumlar daha yavaş, gecikme genellikle biraz kötü ama rekabetçi.
Bağlam için, yazının 86400'e bölme anlık kıyaslaması, Rust ve Zig gibi dillerdeki yerleşik yaklaşımların 1994 tarihli Granlund-Montgomery tekniğinden yaklaşık iki kat yavaş çalıştığını gösteriyor. Rust'ın div_euclid'u yalnızca pozitif bölenler için floor bölmeye denk düşüyor. Yeni yöntem 8, 16 ve 32-bit genişliklerinde de çalışıyor, 32-bit veya SIMD kullanım senaryolarına uygun olabilir ve yan ürün olarak daha hızlı pozitif-modül ve Euclid bölmesi veriyor. Tam kıyarlama bölümü platformlar genelinde 40'tan fazla böleni kapsıyor.
Kullanıma hazır kod ve test
Yazı, -32768'den 32777'ye kadar 65.535 böleni sınayan, sınır testleri de içeren kendi başına çalışan bir C++ dosyası üreten bir üreteç; herhangi bir bit genişliği ve bölenden biri için yapıştırılmaya hazır işlevler üreten bir derleyici ve mikro mimari ayarlarına sahip yeniden kullanılabilir bir C++ template'i sunuyor. Belirtilen lisans yalnızca birebir kopyalar için geçerli; aynı mantığı yeniden uygulamak için gerekmiyor. Yazarın diğer net tavsiyesi ise şu: Kendi hızlı floor bölmenizi elle yazmayın, test edilmiş kodu kullanın.
Neden önemli
Sabitlerle bölme sistem programlamada her yerde: zaman hesapları için 86400, sabit noktalı ölçekleme, takvim döngüleri, uzamsal indeksleme. Negatif işlenenler için doğru davranışa sahip olan floor varyantı, buna karşın ana akım dillerde ya hiç yok ya da yavaş, ara sıra hatalı sürümler halinde sunuluyor. Belgelenmiş ve sınır testlerinden geçmiş, ölçülebilir biçimde 1994'e dayanan teknikleri geride bırakan bir algoritma, derleyici ve standart kütüphane yazarlarına somut bir yükseltme yolu sunuyor; eşlik eden test düzeneği de tam olarak öne çıkan bir kütüphaneyi ısıran taşma hatalarını hedefliyor. Performansa duyarlı kod için, arkasındaki sayılar da olan, doğrudan takılıp kullanılabilir bir mikro optimizasyon.
- #algorithms
- #performance
- #systems-programming
- #integer-division
- #benchmarks