· kaynak Hacker News – Front Page (native)
Yeniden amaçlandırılmış Google embedding modeli, bir saatlik sesi MacBook Air'de ~13 saniyede yazıya döküyor
Hacker News'te öne çıkan bir proje, Google'ın EmbeddingGemma 2'sini, temel düzey bir M3 MacBook Air'de bir saatlik sesi yaklaşık 13 saniyede yazıya döken cihaz üzerinde çalışan bir konuşmadan metne aracına dönüştürüyor.
Embedding modelinden transkript aracına
Google'ın EmbeddingGemma 2'si bir embedding modeli olarak geliştirildi: görevi girdileri vektörlere eşlemek, metin üretmek değil. Hacker News'in ana sayfasına ulaşan eg2.haku.sh adresindeki proje sayfasına göre geliştiriciler, bu modeli Embedding Gemma Transcribe adlı, bir saatlik sesi temel düzey bir M3 MacBook Air'de yaklaşık 13 saniyede, tamamen makinenin kendisinde işleyen bir konuşmadan metne sistemine dönüştürdü.
Dönüşüm nasıl çalışıyor
EmbeddingGemma 2 çok modlu (multimodal): metni, görüntüleri, sesi ve videoyu tek bir paylaşılan vektör uzayına kodluyor. Proje sayfası, sözlü bir kelimenin sesinin bu uzayda o kelimenin yazılı haline doğal olarak yakın konumlandığını açıklıyor; bu yüzden ekip doğrudan bu uzaydan kelimeleri almaya çalışmış.
Uygulamada modelin ses kodlayıcısına (audio encoder) dokunulmamış. Yeni eğitilmiş küçük bir reader bileşeni her kısa ses dilimini modelin metin uzayına eşliyor ve yaklaşık 229.000 İngilizce kelime arasından en yakın olanı çıktı olarak seçiliyor. Ardından ayrı, çok küçük bir model noktalama ve büyük harf kullanımını ekliyor.
Eğitim maliyetleri mütevazıydı. Yalnızca reader eğitildi; projeye göre bu, açık lisanslı İngilizce konuşma verisiyle sekiz H100 GPU'da iki saatten az sürdü. Temelindeki Google modeli hiçbir zaman transkripsiyon için eğitilmedi.
Hız rakamları
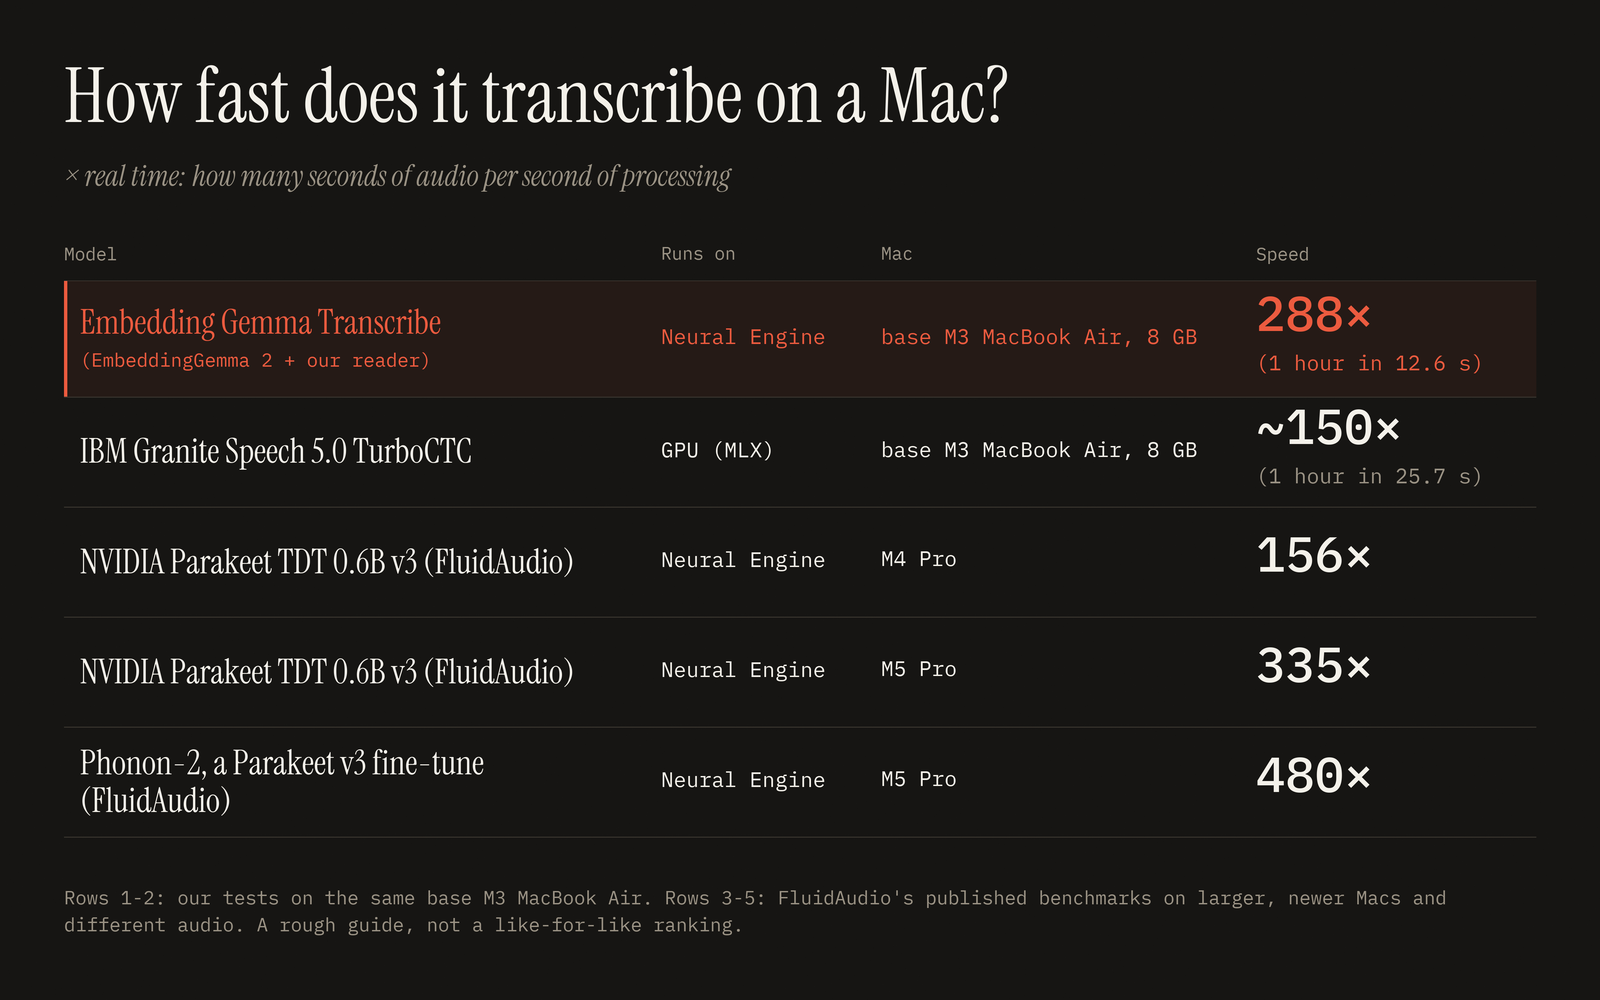
8 GB RAM'li temel düzey bir M3 MacBook Air'de, Apple'ın Neural Engine üzerinde çalışan proje, 288x gerçek zamanlı aktarım hızı bildiriyor: bir saatlik ses 12,6 saniyede. Aynı dizüstü bilgisayarda geliştiriciler, MLX üzerinden GPU'da çalışan IBM'nin Granite Speech 5.0 Turbo CTC modelini yaklaşık 150x, yani saatlik ses başına 25,7 saniyede ölçtü.
Karşılaştırma için sayfada FluidAudio'nun yayımlanmış kıyaslamalarındaki rakamlara da yer veriliyor: NVIDIA'nın Parakeet TDT 0.6B v3 modeli M4 Pro'da 156x ve M5 Pro'da 335x; Parakeet'in ince ayarlanmış hali olan Phonon-2 ise M5 Pro'da 480x. Geliştiriciler, bu satırların daha yeni ve daha güçlü makinelerde, farklı seslerle ölçüldüğünü, dolayısıyla adil bir başa baş karşılaştırma değil, yol gösterici olarak okunması gerektiğini belirtiyor.
Asıl sorun doğruluk
Hız tüm tablo değil. Proje şu anda yaklaşık %5'lik bir kelime hata oranı bildiriyor; önde gelen konuşma modellerinde bu oran %2-3. Geliştiriciler bu açığı reader bileşenine bağlıyor ve daha iyi eğitilmiş bir sürümün bir sonraki adım olduğunu söylüyor.
Gerçekte neyi çalıştırabilirsiniz
Araç ücretsiz bir Mac uygulaması olarak geliyor, şu anda 1.6 sürümünde ve Apple Silicon'da macOS 14 veya daha yeni bir sürüm gerektiriyor; yaklaşık 715 MB'lık modeller ilk açılışta indiriliyor. Transkripsiyon için ses dosyalarını kabul ediyor ve sağ Option tuşunu basılı tutup konuşarak ve bırakarak herhangi bir uygulamaya dikte desteği sunuyor. Her şey Neural Engine üzerinde çalışıyor ve geliştiriciler sesin her zaman makinede kaldığını belirtiyor.
Neden önemli
Bu demo iki açıdan etkileyici. Birincisi, saf yerel performans: fansız, giriş seviyesi bir dizüstü bilgisayarda bir saatlik sesin yaklaşık 13 saniyede işlenebilmesi, cihaz üzerinde transkripsiyonun pek çok kullanım senaryosunda bulut iş akışlarının yerine geçebilecek kadar hızlı olabileceğini gösteriyor; üstelik kayıtların makineden asla çıkmaması gibi bir gizlilik avantajıyla birlikte.
İkincisi, yöntemin kendisi. Yalnızca çok modlu girdileri gömmek (embed) için eğitilmiş bir model, barındırdığı yapı sayesinde küçük ve ucuz eğitilmiş bir adaptörle üretken bir göreve yönlendirilebiliyor. Doğruluk açığı kapanırsa, donmuş bir kodlayıcı (frozen encoder) artı hafif bir reader tarifinin başka görevlerde, başka modlarda ve başka dillerde de denenmesi makul görünüyor. Şimdilik iddialar geliştirici tarafından bildiriliyor ve hata oranı en iyi sistemlerin kabaca iki katı olarak durduğundan, bu, yerleşik konuşma modellerinin anında yerine geçecek bir çözüm değil, ikna edici bir kavram kanıtı olarak okunmalı.
- #on-device-ai
- #speech-to-text
- #apple-silicon
- #embedding-models
- #local-inference