· kaynak Hacker News – Front Page (hnrss.org)
AlphaNIST: tek bir policy, ikili bir ödülden NIST'in 20 montaj görevinin tamamını öğreniyor
Bir proje sayfası ve arXiv makalesi, 4 mm'ye kadar küçük parçalar dahil NIST'in montaj benchmark'ındaki yirmi görevin tamamını yalnızca başarı veya başarısızlık sinyaliyle eğitilmiş tek bir öğrenilmiş policy'nin tamamladığını anlatıyor.
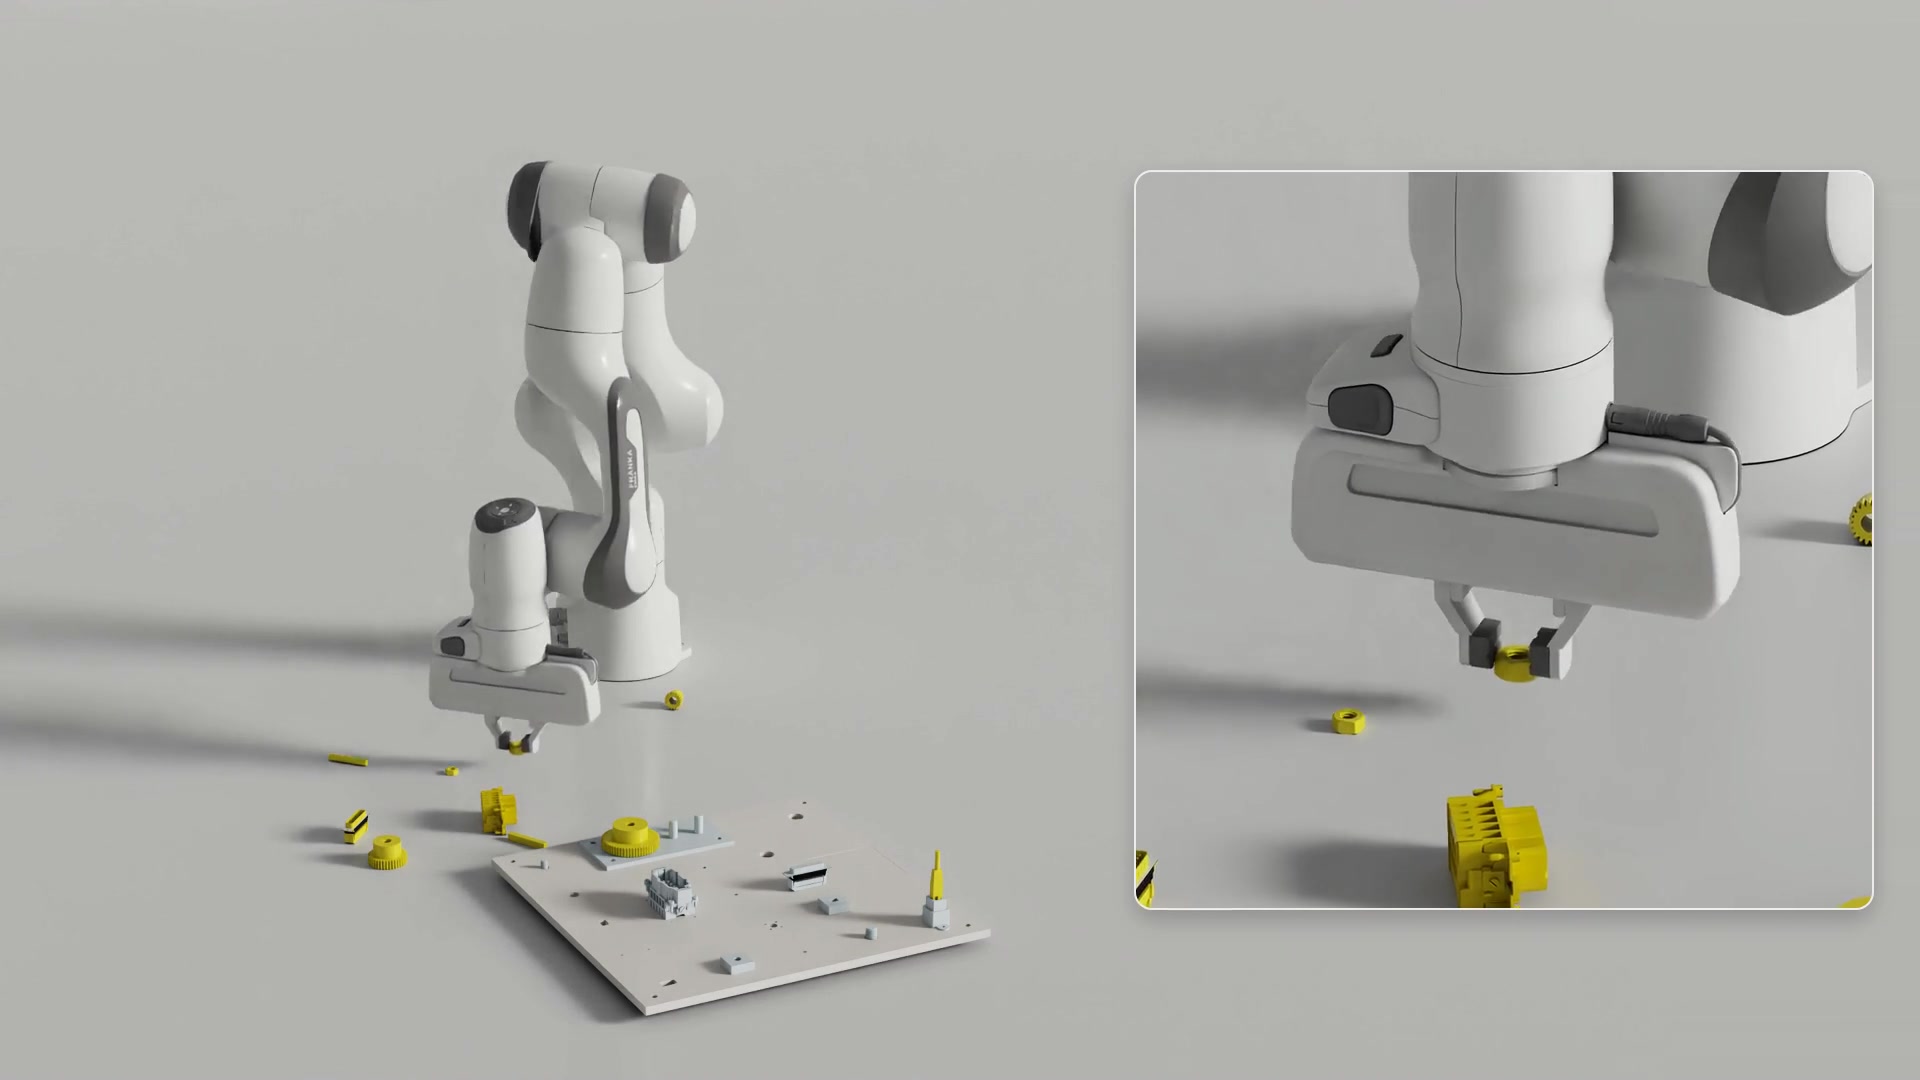
Tek policy, yirmi montaj
AlphaNIST adlı bir robotik projesi, 4 mm'ye kadar küçük parçalar içeren ince manipülasyon benchmark'ı NIST Assembly Task Board #1 üzerindeki yirmi görevin tamamını, elden geldikçe sadece bir başarı sinyaliyle eğitilmiş tek bir öğrenilmiş policy'nin yerine getirdiğini gösteriyor. Bu çalışma, proje sitesinde ve Octi Zhang, Iretiayo Akinola, Yashraj Narang ve diğer yazarların kaleme aldığı AlphaNIST: Emergent Assembly Skills from Binary Task Rewards başlıklı arXiv ön baskısında (2610.13354) tanımlanıyor. Çalışma Hacker News'in ana sayfasına ulaştı.
Hassasiyetsizliği affetmeyen bir benchmark
NIST tahtası, yirmi montaj işlemini tek bir test düzeneğine sığdırıyor. AlphaNIST proje sayfasına göre tek bir parçayı bile yerleştirmek, gripper'ın parçayı birkaç kez yeniden kavramasını ve yönlendirmesini gerektirebiliyor; boşluklar öyle dar ki bir somun yanlış açıyla girerse sıkışabilir ya da dişleri bozabilir. Birden fazla parça içeren görevler bir de planlama katmanı ekliyor: yerleştirilmiş bir bileşen, sonraki bir yerleştirmede gripper'ın önünü kesebiliyor; dolayısıyla işlem sırası önemli.
Talimat yerine ödül
Ekibin çıkış noktası, bu manevraların elle betimlenmesinin kırılgan olduğu. Her hareketi yazıya dökmek, robotun temaslar ve engeller değiştikçe nasıl tepki vereceğini önceden kestirmek anlamına geliyor; iki parmaklı bir gripper da çoğu zaman insan elinin aklına gelmeyecek stratejilere ihtiyaç duyuyor. Araştırmacılar bunun yerine gözetimi ikili bir görev ödülüne, yani başarıya ya da başarısızlığa indirgedi ve policy'yi simülasyonda büyük miktarda çeşitli deneyimle eğitti. Bu, özünde pekiştirmeli öğrenme: policy yalnızca sonuçlardan iyileşiyor. Sayfanın iddiasına göre bu, robotun hiçbir mühendisin aklına gelmeyecek çözümler bulmasına alan bırakıyor; makalenin başlığı bunu "ortaya çıkan montaj becerileri" olarak çerçeveliyor.
Eğitim verisi nasıl şekillendiriliyor
İki mekanizma işi görüyor. İlki çeşitli başlangıç durumları: tek bir policy yirmi birbirinden farklı montajın tamamı üzerinde eğitiliyor ve bölümler, dağınık parçalardan, gripper'da hâlihazırda tutulan bir parçadan ya da simülasyonda saklanan bir önbellekten çekilen kısmen tamamlanmış bir montajdan başlayabiliyor. Bölümlerin tamamlanmaya yakın başlaması, robotu uçtan uca bir montajı tamamlayabilmeden önce bitirmeyi prova etmesine olanak tanıyor. Önbellek yalnızca başlangıç durumlarına katkı sağlıyor, gösterimlere değil; dolayısıyla sürece insan örneği girmiyor.
İkincisi, başarıya yönlendirilmiş örnekleme. Eğitim bölümleri, mevcut policy'nin yaklaşık yarısında tamamlayabildiği başlangıç durumlarını yeğleyen Beta örneklemesiyle seçiliyor; yani öğrenmek için yeterince zorlu ama ödül sinyalinin hiç tetiklenmeyeceği kadar da zor olmayan durumlar. Her durumun seçilme olasılığı bir miktar korunuyor ve ağırlıklar sonuçlar değiştikçe kayıyor; böylece başka yerlerdeki ilerlemeyle yeni çözülebilir hale gelen bir durum, zamanla daha çok pratik çekiyor.
Gerçekte ne çalıştırıldı
Sayfa tek bileşenli bir montaj deneyi anlatıyor: tek bir policy yirmi görevin tamamını, her çalıştırmada bir bileşen monte edecek şekilde icra ediyor. Bu, sayfanın kendisinin zorlu vaka olarak çerçevesine oturttuğu, sıralama ve engelleme devreye giren çok parçalı senaryonun kısa bir adım gerisinde; ve şimdiye dek yayımlanan materyalde bu daha zorlu ortam için hiçbir sonuç raporlanmamış.
Neden önemli
Milimetre ölçeğinde ince montaj, robotikte inatçı bir boşluk. İnsan ellerinin hissederek idare ettiği toleranslar betimlenmiş makineleri çoğu zaman yeniyor; görev başına mühendislik de otomasyonu yüksek hacimli üretimin dışında ekonomik olmaktan çıkarıyor. Tek bir policy ve tek bir ikili ödülden yirmi heterojen görev çıkaran bir reçete, özel programlamadan çok genelci manipülasyona işaret ediyor; önbelleğe alınmış kısmi montaj durumları ve başarı oranına göre ağırlıklandırılmış örnekleme bu iki eğitim hilesi de başka ekiplerin yeniden kullanabileceği, görevden bağımsız fikirler. Sayfanın kendisinin gündeme getirdiği açık soru, sıralama ve engelleme içeren çok parçalı montaj; bunun yanıtı, sonucu etkileyici bir benchmark başarısından gerçek üretim ortamları için pratik bir şeye doğru taşıyacak.
- #robotics
- #reinforcement-learning
- #robot-manipulation
- #benchmark
- #assembly