· kaynak Hacker News – Front Page (native)
İnce ayarlanmış Qwen3-4B, yapay zekâ yazım kalıplarından arındırıldı — ve bir MacBook Air'de eğitildi
Bir geliştirici, em dash ve üçlü listeler gibi yapay zekâ yazım kalıplarını kaldırmak için Qwen3-4B-Instruct modeline bir MacBook Air üzerinde ince ayar yaptı; 1000 kelimede slop puanı 121'den 12,5'a düştü. Model Ollama üzerinden yerel olarak çalışıyor.
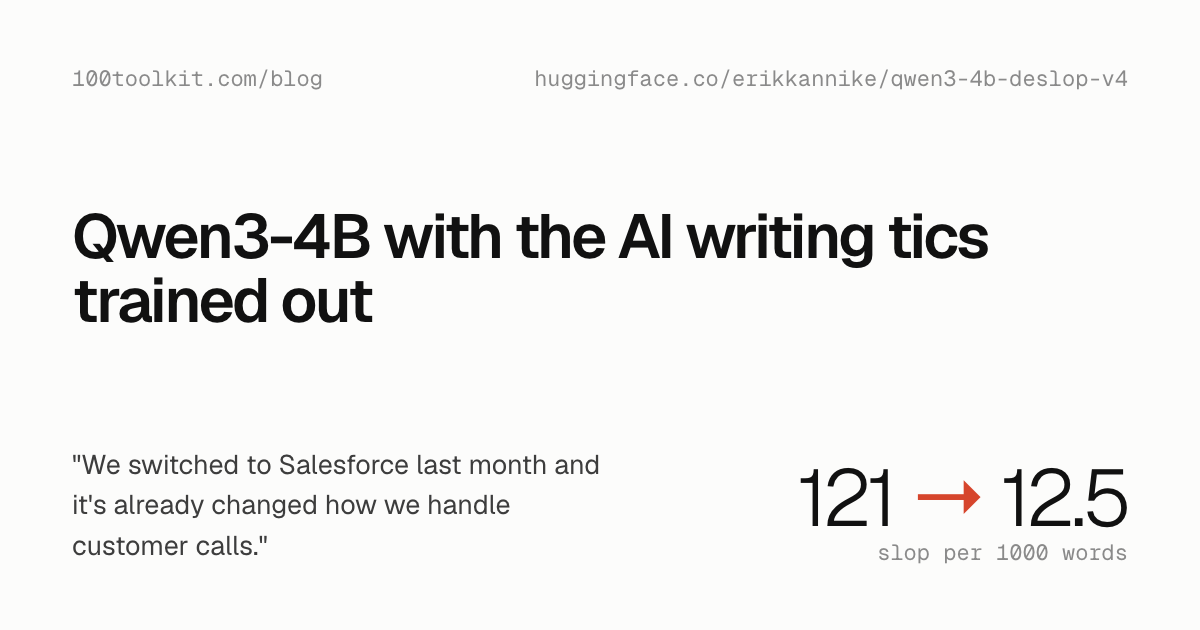
Bir geliştirici, okuyucuların artık makine üretimi metinle özdeşleştirdiği dilsel alışkanlıklardan arınmış yazılar üretmesi için Qwen3-4B-Instruct'a ince ayar yaptı ve tüm işi bir MacBook Air üzerinde tamamladı. qwen3-4b-deslop adıyla yayımlanan modelin, em dash'lerden, "X değil, Y" kalıplarından ve üçlü listelerden kaçınması için herhangi bir system prompt'a ihtiyacı yok; 100toolkit.com'da yayımlanan ve Hacker News'te paylaşılan yazıya göre model Ollama üzerinden çevrimdışı çalışıyor.
Eğitimde hiç görülmemiş 40 prompt üzerinde yazar, yapay zekâ tarzı kalıpların ağırlıklı sayısının stok modelde 1000 kelime başına 121'den 12,5'a düştüğünü, yanıtların yüzde 68'inin insan yazımına özgü aralığa girdiğini bildiriyor. Em dash kullanımı 1000 kelimede 20,5'ten sıfıra indi. İnce ayarlanmış model 30 bilgilendirici sorunun 30'unu da doğru yanıtladı ve istenen tür ve uzunlukla uyumu orijinal modelle aşağı yukarı aynıydı.
Kalıpların ölçülmesi
Öne çıkan sayı, yazarın yapay zekâ yazım alışkanlıklarını derlediği bir stil kılavuzundan oluşturduğu bir algılayıcıdan geliyor: em dash, "X değil, Y" kalıbı, üçlü gruplar, olduğu yerde yanıtlanan retorik sorular, "işin özü şu" gibi işaret ifadeleri, vurgu için kullanılan kısa parçacıklar ve "delve", "seamless" gibi kelimeler. Her alışkanlığın bir ağırlığı var ve puan 1000 kelime başına ağırlıklı bir sayım; özenli insan metni sıfıra yakın puan alıyor.
Kalıp sayımları yazım kalitesini yargılayamayacağı için, aday modellerin her biri hasar açısından da incelendi. Yazar, tahminlerin 22 insan yazısı parçasında ne kadar saptığını ölçtü, 30 soruluk bilgi testini uyguladı, harfle başlamayan cümleler gibi bozuk çıktıları işaretlemek için kural tabanlı denetimler kullandı ve örnekleri elle okudu.
Üç tur damıtma
Çalışma, daha önceki iki bulguya dayanıyor. Model yazarken ondan bir "asistan üslubu" yönünün çıkarılması, sade bir system prompt ile birleşince puanı yaklaşık 15'e indirdi; ancak bu yöntem, üretim sırasında çalıştırılan prompt'a ve koda ihtiyaç duyuyor ve modelin olağan metinler üzerindeki davranışını değiştiriyordu. Ayrıca, dört nöronun işaretinin ters çevrilmesi neredeyse hiçbir bedel ödemeden "X değil, Y" kalıbının yüzde 70'ini kaldırdı; ama yalnızca bu tek alışkanlığı.
Düzeltmeleri ağırlıkların içine taşımak için yazar damıtmayı kullandı: O ana kadarki en iyi tekniklerle oluşturulan bir öğretmen model 288 eğitim prompt'unu yanıtladı, denetimlerden geçen yanıtlar tutuldu ve küçük bir LoRA adaptörü bunları yalın prompt'tan yeniden üretmeyi öğrendi. İlk tur, prompt'suz ve runtime kancaları olmadan yaklaşık 20'lik bir puana ulaştı.
İkinci tur daha iyi puan aldı ama daha kötü yazdı. Öğrenci model 9,9'a indi; ancak görüş yazıları hiçbir zaman bir tutum belirtmiyordu, ev bitkileriyle ilgili bir yanıtta modelin uydurduğu bir araştırmaya atıf yapıyordu ve cümleler orijinalin 28 katı sıklıkla ", ki" ya da ", böylece" bağlantılarıyla zincirleniyordu — yazar bu alışkanlığın kaynağını kendi öğretmen prompt'unda ve iki taklit turunda buldu. Model istenen görevi yalnızca yüzde 60 oranında yerine getirdi; stok modelde bu oran yüzde 78'di.
Üçüncü öğretmene görevi öncelemesi söylendi: sorulduğunda bir tutum benimse, kişisel yazılarda birinci ağıdan yaz, cümleleri çeşitlendir, araştırma veya isim uydurma. Prompt başına üç yanıt üretildi ve yalnızca 12'nin altında puan alan ve tüm denetimlerden geçen yanıtlar — yaklaşık yüzde 30 — tutuldu; bu yanıtlar 288 prompt'un 161'ini kapsıyordu. Bu yanıtlarla eğitilen model, yayımlanan model: 12,5'luk bir puan, yüzde 80'e geri dönen görev uyumu ve neredeyse tamamen ortadan kalkan uydurma araştırmalar ve yüzdeler.
Yerel olarak çalıştırma
Nicemlenmiş Q4_K_M derlemesi, Ollama ya da llama.cpp üzerinden çalışan 2,5 GB'lık bir indirme; tam hassasiyetli ağırlıklar ise herhangi bir Qwen3-4B checkpoint'u gibi standart transformers arayüzüyle yükleniyor. Depo parçaları da ayrıca yayımlıyor: 126 MB'lık LoRA adaptörü ve nöron düzenlemesi — dört ağırlık sütununun ve ölçeklerinin 175 baytlık listesi. Adaptör, düzenleme etkinken eğitildi; dolayısıyla ikisinin birlikte kullanılması amaçlanıyor.
Bilinen sınırlamalar
Yazar ödünler konusunda açık sözlü. Üslup, düzleşme noktasına varacak kadar sade; kısa bildirme cümlelerinden oluşan diziler var ve model hâlâ isim ve yer uyduruyor, çünkü her turda somut ayrıntı ödüllendirilmişti. Yanıtlar uzunu çekiyor: yaklaşık 150 kelime istendiğinde çoğu zaman 200'e yakın metin geliyor. Yalnızca kısa İngilizce metinler test edildi; kod, uzun konuşmalar, diğer diller ve araç kullanımı orijinalden daha iyi olmayabilir, hatta daha kötü olabilir. Puan, düzenli ifadelerle ifade edilmiş bir stil kılavuzu; okuyucularla kör test yapılmadı ve sonuçlar çalıştırmalar arasında değişiyor — aynı model adaptör aracılığıyla 10,2, birleştirilmiş ağırlıklarla yalnızca örnekleme farklarından dolayı 12,5 puan aldı.
Neden önemli
Bu, dar ve iyi tanımlanmış bir davranışın, küçük bir açık modelin ağırlıklarından düşük maliyetle, tüketici donanımında, runtime yönlendirmesi ve system prompt olmadan çıkarılabileceğinin bir kanıtı. Aynı zamanda eniyileştirme üzerine bir ibret dersi: slop puanının tek başına peşinden koşmak, açık denetimler eklenene kadar görev performansını sessizce düşürdü ve her öğrenci ancak öğretmeni kadar iyi olabildi. Yazar, tarifin model boyutuna bağlı olmadığını söylüyor ve insan yazısından derlenen bir kümeyle oluşturulacak daha iyi bir öğretmenle tarifi daha büyük modellerde çalıştırmayı planlıyor. Yapay zekâ destekli ama yapay zekâ gibi okunmayan metinler isteyen herkes için 2,5 GB'lık yerel bir model artık çalışan bir seçenek.
- #open-source
- #fine-tuning
- #language-models
- #ollama
- #qwen