· kaynak Vercel blog
Vercel, yazılımınızı kullanan yapay zeka ajanları için uçtan uca eval'lerin nasıl kurulacağını anlatıyor
Yeni bir Vercel rehberi, geliştiricileri üç katmanlı test piramidinden pass@k ve pass^k gibi metriklere kadar yapay zeka ajanlarını uçtan uca test etme sürecinde adım adım gezdiriyor; açık kaynak bir framework olan Harbor kullanılıyor.
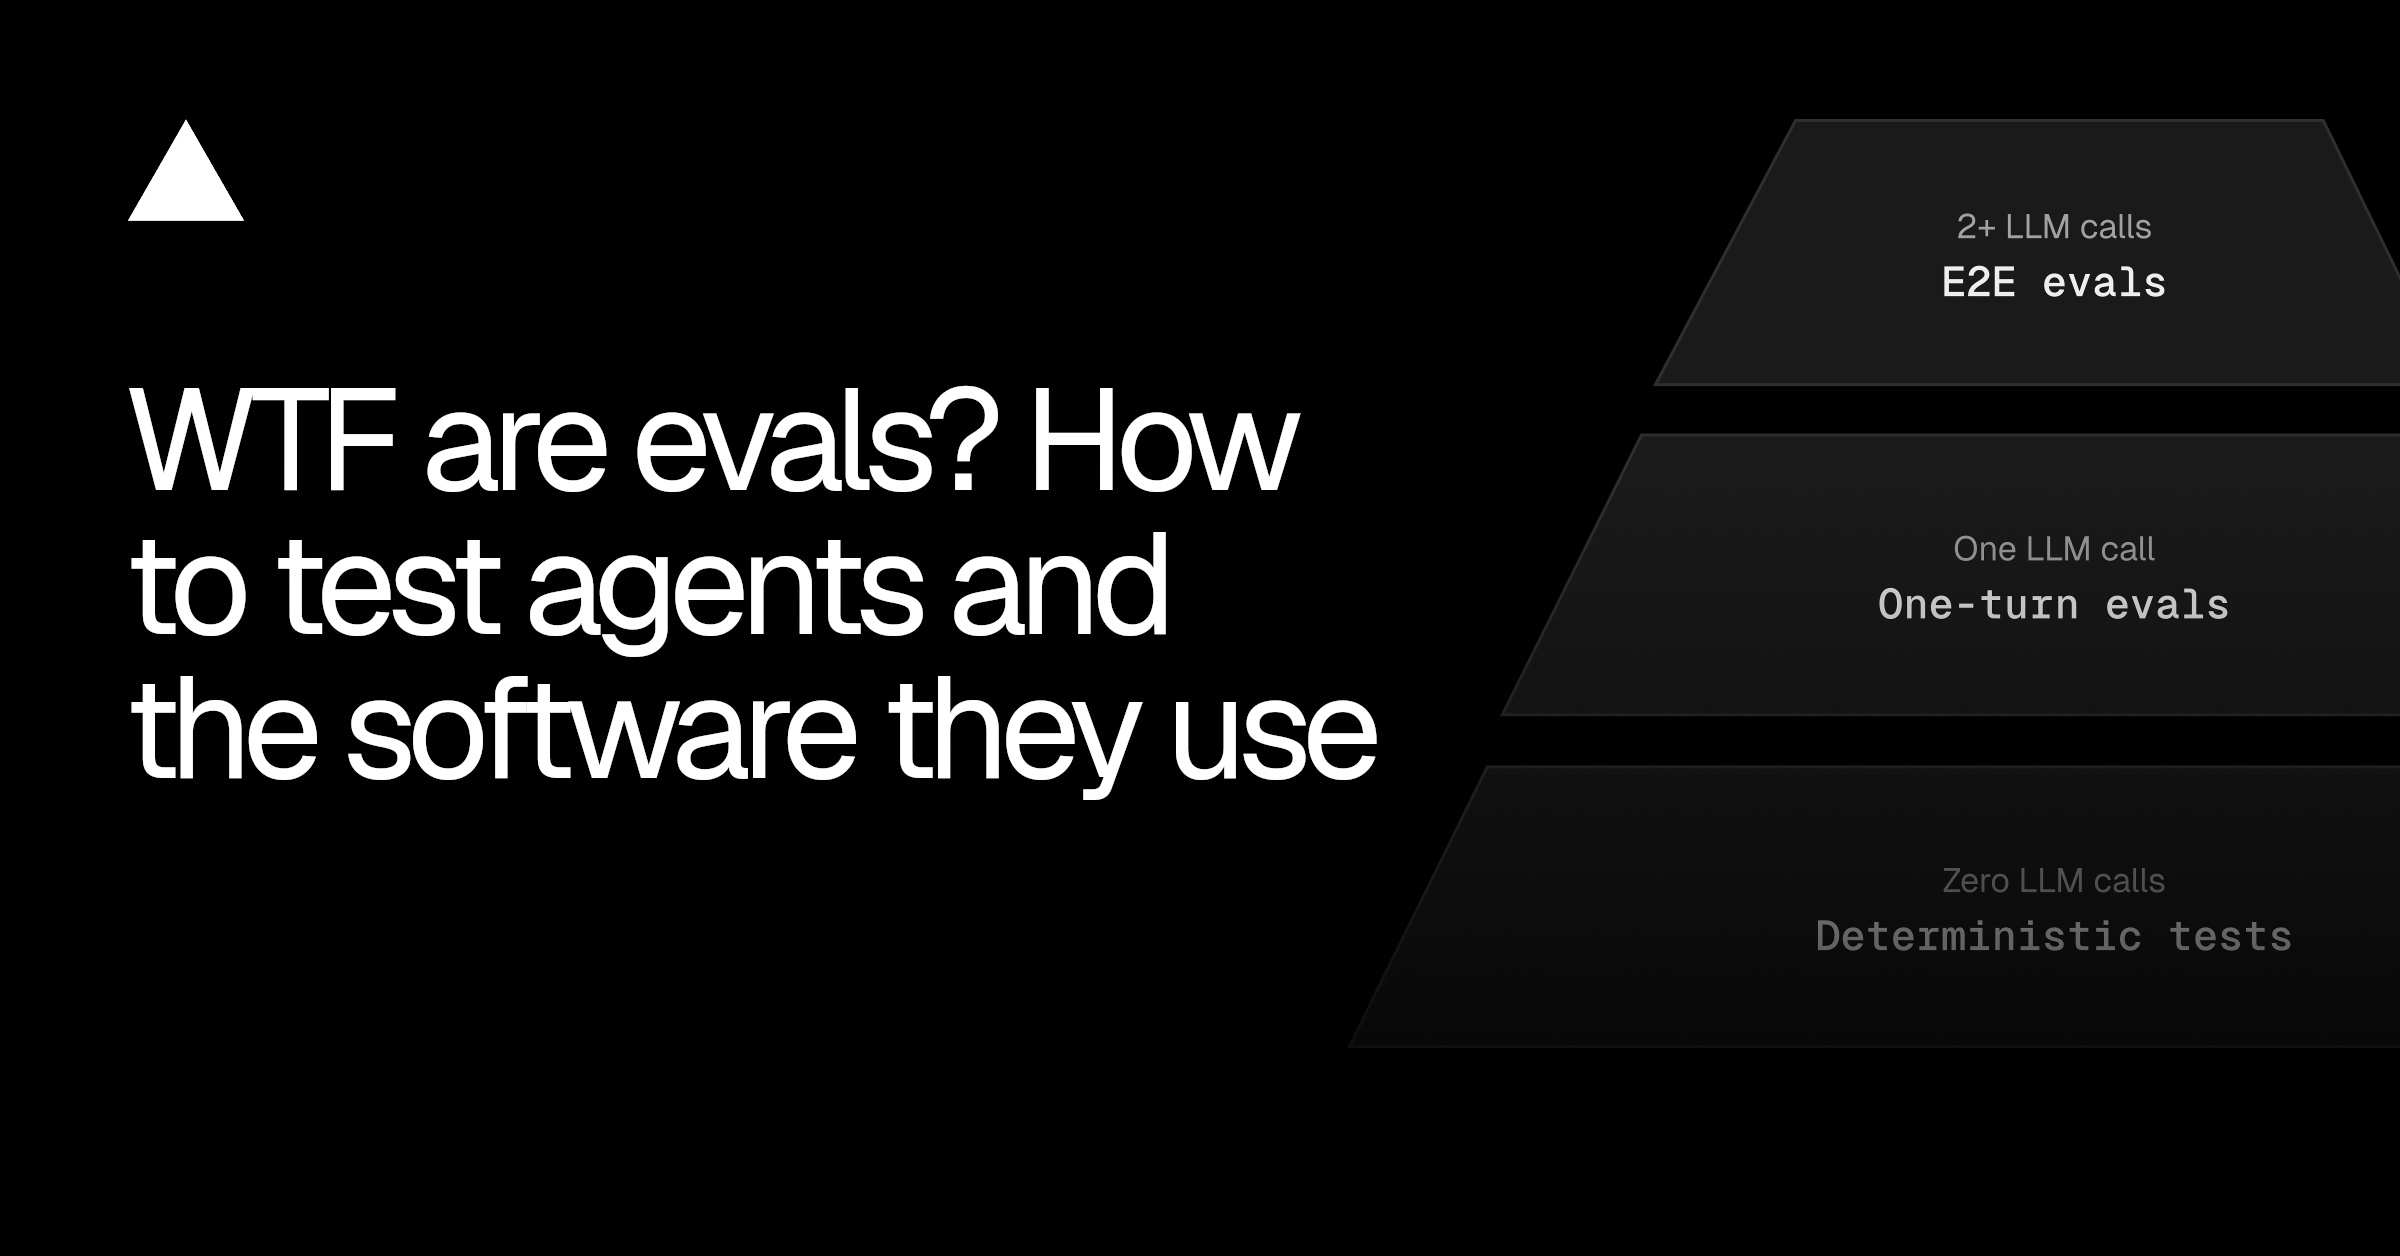
Vercel, hem ajanların kendisini hem de ajanların tükettiği yazılımı — API, CLI, SDK ve MCP server'ları — geliştiren ekipleri hedefleyen, yapay zeka ajanları için eval'lere dair pratik bir rehber yayınladı. Yazıya göre ajanlar artık insan kullanıcının geçtiği huninin aynısından geçiyor — keşif, seçim, erişim ve başarı — ve eval'ler de son aşamayı ölçmenin yolu: ajanın kullanıcının görevini gerçekten doğru şekilde tamamlayıp tamamlamadığı.
Bu, göründüğünden daha zor bir kontrol oluyor. Vercel'e göre bir ajan, teknik olarak bir isteği tamamlayabilir ama kullanıcıyı hayal kırıklığına uğratabilir; istenen buzlu latte yerine sıcak latte sipariş edebilir. İstek başarılı olduğu için gözlemlenebilirlik (observability) kayıtları sağlıklı görünür. Ayrıca LLM çıktısı çalıştırmadan çalıştırmaya değiştiği için, tek bir başarılı manuel test, bir düzeltmenin gerçekten işe yarayıp yaramadığı hakkında hiçbir şey söylemez. Aynı görevi tekrarlamalı, sonucu puanlamalı ve her değişiklikten önce ve sonra sonuçları toplulaştırmalısınız.
Ajan odaklı test piramidi
Vercel, ajan testlerini gerektirdikleri LLM çağrısı sayısına göre düzenliyor: hiç çağrı gerektirmeyen deterministik testler, tek çağrı gerektiren tek turluk (one-turn) eval'ler ve tam bir görevi kapsayan uçtan uca eval'ler. Şirkete göre bu sayı, her testin emek, runtime ve maliyeti için iyi bir göstergе olmuş; bu yüzden ucuz ve hızlı katmanlar bir test paketinin büyük kısmını oluşturmalı — klasik test piramidinin ajan tatlı bir uzantısı. Pratik kural, yakalamak istediğiniz sorundan başlamak ve onu yakalayabilecek en düşük katmanı seçmek.
Tek turluk eval'ler tek bir kararı kontrol eder; örneğin ajanın ilk olarak hangi komutu çalıştırdığını. Ama başarı tüm adım dizisine bağlıdır ve Vercel, her adımın tek başına makul görünürken nihai sonucun yine de yanlış olabileceğine dikkat çekiyor. Bu yüzden Success aşaması E2E eval'ler gerektiriyor — ve yazı, SWE-bench ve Terminal-Bench gibi bilinen kodlama benchmark'larının zaten bu desene uyduğunu belirtiyor.
Bir kahve siparişi örnek çalışması
Rehber örneğini, ajanlara sfbeans adlı bir CLI üzerinden sunulan kurgusal bir kahve siparişi API'si olan SF Beans üzerinde kuruyor. Tipik bir müşteri isteği, San Francisco'nun Mission semtinde, tam yağlı sütlenen, sabah 9:00'a kadar hazır olacak ve bahşiş dahil 8 doların altında büyük bir buzlu latte istiyor. Örnek verideki yakın dört kafeden üçü ayrı ayrı bir kısıtı ihlal ediyor — buzlu içecek yok, vergi ve bahşiş eklendiğinde bütçeyi aşıyor, teslimat çok geç — ve geriye tam olarak tek bir geçerli seçenek kalıyor. Ajanın bu seçeneğe ulaştığını yalnızca tam görev değerlendirmesi doğrulayabilir.
Vercel, eval'i Harbor ile uyguluyor; Terminal-Bench'ın yaratıcılarından gelen bu açık kaynak framework, ajanları container'lar içinde çalıştırıyor, eylemlerini kaydediyor ve sonuçları kontrol ediyor. Yazı sözlüğünü tanımlıyor: bir task, başlangıç ortamı ve başarı kontrolü olan tek bir problem; bir variant, test edilen ajan kurulumu — model, prompt, araçlar, bellek ve beceriler gibi; bir trial, bir variant'ın tek bir denemesi; bir run, her görevde her variant'ı kapsıyor; bir trace ise bir deneme sırasında gerçekleşen her şeyi kaydediyor.
Bir LLM'nin bir ürünle yapabileceği her şeyin tam kapsamını sınırlamak bile pratik olmadığından, rehber gözlemlenebilirlik verileri, müşteri destek kayıtları ve kayıp (churn) ya da ürün yol haritası aracılığıyla bulunabilen, dar ve kullanıcıyla ilgili tek bir hedefle başlamayı öneriyor. Örnekte en sık destek şikayeti — ajanların yanlış içecek sipariş etmesi — hedefi belirliyor.
Doğru metriği seçmek
Vercel'in temel metrikleri başarı oranı, pass@k (k denemenin en az birinin geçme şansı; ajanın görevi hiç yapip yapamadığını yanıtlar) ve pass^k (k denemenin tamamının geçme şansı; her seferinde güvenilip güvenilemeyeceğini yanıtlar). Verimlilik ölçümleri — adım, süre ve dolar maliyeti — yalnızca başarılı denemelerde sayılıyor.
Örnek çalıştırmada, Claude Code, Anthropic'in Opus 5.5'iyle eşleşerek buzlu latte görevini beş denemeden üçünde tamamladı: yüzde 60 başarı oranı, kabaca yüzde 99 pass@5 ama yalnızca yaklaşık yüzde 8 pass^5. Her iki rakam da doğru ve sadece farklı soruları yanıtlıyor. Bir hatanın kullanıcının yanlış içecek için ödeme yapması ve yeniden deneme şansının olmaması anlamına geldiği günlük kahve siparişi için Vercel, sfbeans'in pass^k için optimize edeceğini söylüyor; başarısız bir denemenin ucuz ve erken yakalandığı ürünler ise pass@k ile yetinebilir.
Yazı, metrik tartışmasını iki uyarıyla kapatıyor: genel ortalamalar sık sık başarısız olan tek tek görevleri gizleyebilir, bu yüzden sonuçlar görev bazında incelenmeli; ve kusursuz birkaç deneme, hatanın imkansız olduğunu değil, henüz gözlemlenmediğini gösterir.
Neden önemli
Ajanlar gerçek bir dağıtım kanalı haline geliyor — Vercel'in örneği, user-agent başlıkları aracılığıyla Claude Code ve Codex gibi araçlardan gelen ajan trafiğini tespit ediyor — ve bu ajanların kullandığı API ve CLI'ların yapımcıları, deterministik olmayan kullanıcılara göre tasarlanmış bir test disiplinine ihtiyaç duyuyor. Rehber aktarılabilir bir reçete sunuyor: testleri ucuz şekilde yerleştirmek için piramidi kullanın, tam görev eval'lerini Harbor gibi bir framework'te çalıştırın ve bir hatanın kullanıcınıza gerçekte neye mal olduğuna uyan metriği — pass@k veya pass^k — seçin.
- #ai-agents
- #evals
- #llms
- #testing
- #developer-tools